

- 2026/11/13 06:50 掲載
【フィジカルAI】エヌビディアや東大など識者激論、「世界モデル」に潜む日本の勝ち筋



「フィジカルAIでも、日本は米中に負けるのか?」。中国では人海戦術でロボットの学習データを集め、米国ではエヌビディアが世界モデルを開発するなど、競争が激化している。そんな中、「今やらないと間に合わない」と有識者は強烈な危機感を示す。だが、実は日本の製造業にも、米中に対抗できる意外な武器があるという。それは一体何なのか。今回、Xinobi AI 共同CEOの馬渕 邦美氏をモデレーターに、エヌビディア エンタープライズ事業本部 事業本部長の井﨑 武士氏、東京大学 生産技術研究所 特任教授/建築家の豊田 啓介氏、ゲームAI研究者の三宅 陽一郎氏が集結し、フィジカルAIによる変化や日本の勝ち筋、世界モデルの中身などについて激論を交わした。
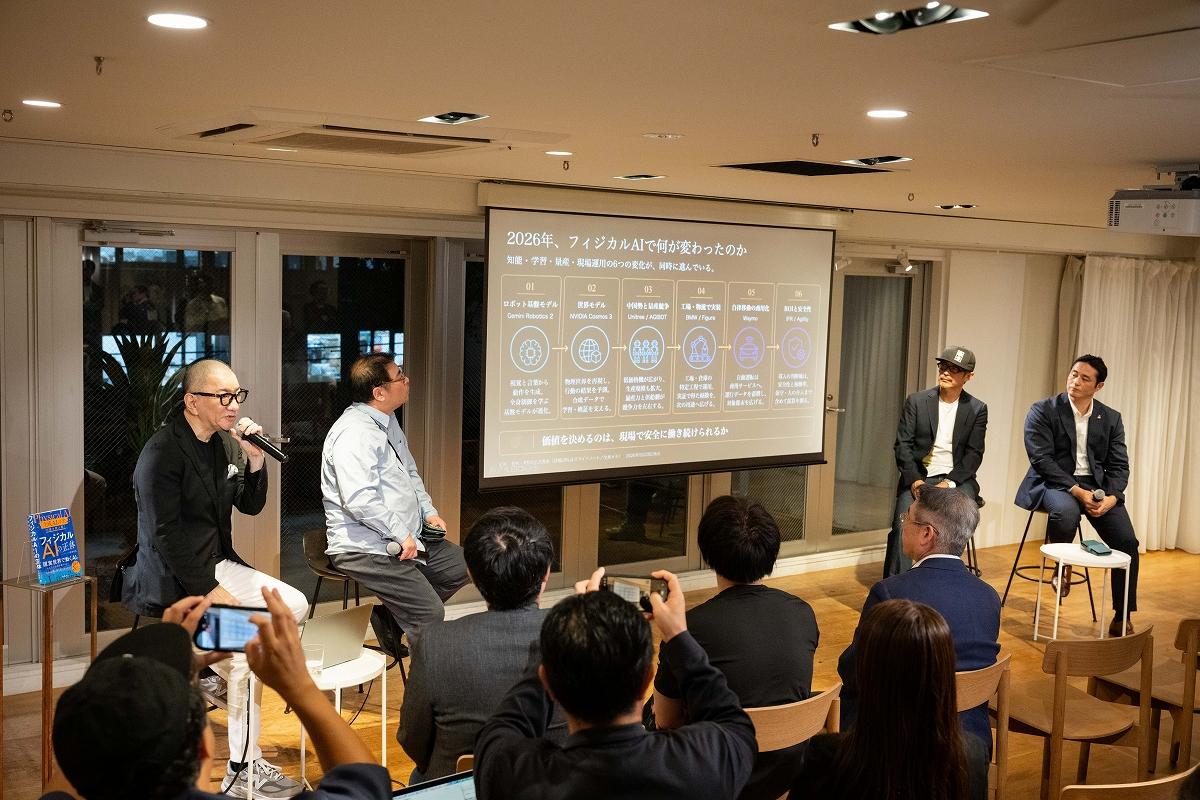
本記事は2026年9月28日開催「馬渕邦美 新刊出版記念イベント」で行われた座談会セッションを基に再構成したものです。記事の内容はイベント当時のものです。
2026年に起きた、フィジカルAI「6つの変化」
フィジカルAIという言葉は2026年に一気に広まったが、その中身はまだ「ふわっとしている」と馬渕氏は指摘する。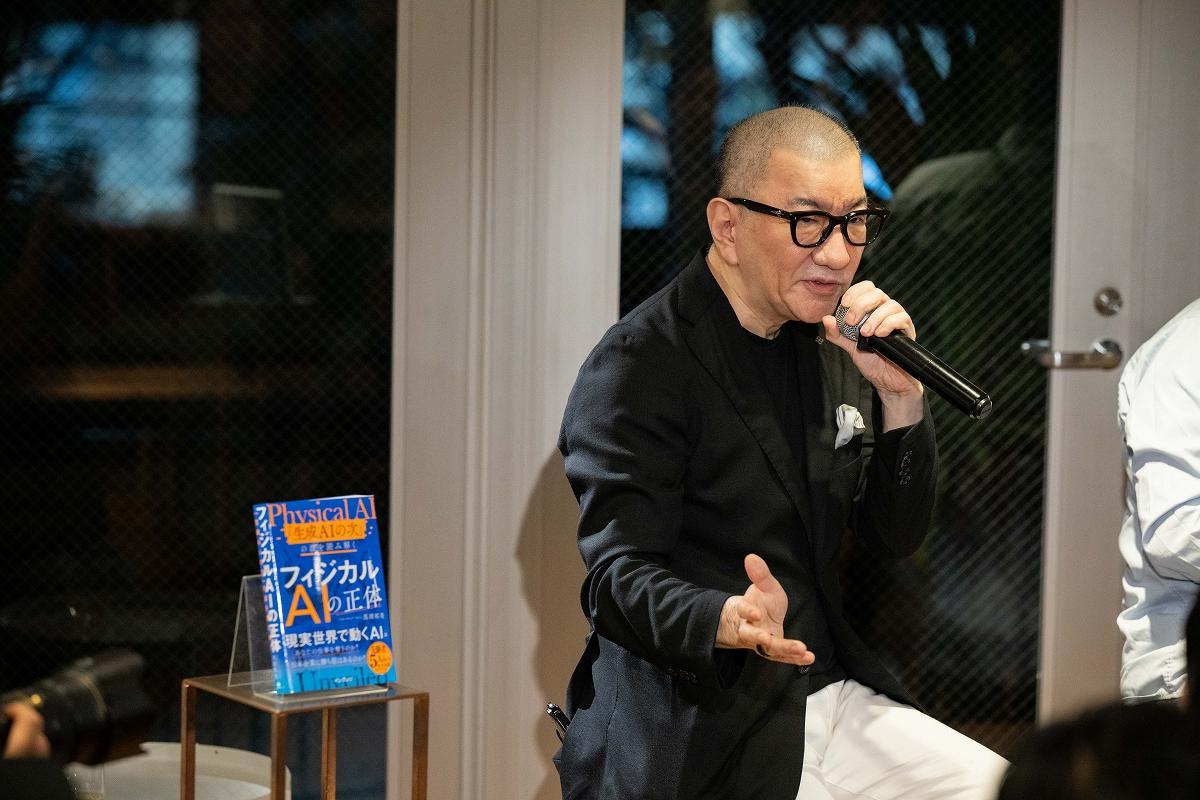
「フィジカルAIは総合格闘技のようなところがあります。AIもあれば、ヒューマノイドロボットもある。シミュレーションやロボットを動かすモデルなど、さまざまなレイヤーが存在するのです」(馬渕氏)
フィジカルAIと聞くと、中国のロボット競技大会(世界ヒューマノイドロボット競技大会:2026年8月、北京にて開催)でヒューマノイドが転倒する映像を思い浮かべる人も多いだろう。だが馬渕氏によれば、それはごく一部にすぎない。実はこの大会には51種類もの競技があり、工場や物流、ホテルなど、社会実装を見据えた競技も含まれていたからだ。
一方、フィジカルAIを進めるにあたり、その難しさも指摘される。その最大の壁は「学習データ」だ。生成AIはインターネット上などに蓄積された膨大なテキストを学習して進化したが、フィジカルAIはロボットの動作や物理現象を学ぶためのデータが圧倒的に不足している。
コップを持つという動作でさえ、関節のモーターをどう動かすかの元データがなければ学習できない。そのため中国では、人が動作を繰り返してデータを生み出す「データ工場」まで登場している。
こうした状況を踏まえ、馬渕氏は「2026年、フィジカルAIで何が変わったのか」として次の6つの変化を提示した。
(1)ロボット基盤モデル(Gemini Robotics 2)
(2)世界モデル(NVIDIA Cosmos 3)
(3)中国勢と量産競争(Unitree/AGIBOT)
(4)工場・物流での実装(BMW/Figure)
(5)自律移動の商用化(Waymo)
(6)ROIと安全性(IFR/Agility)
今回の座談会は、この中から各パネリストが関心のあるテーマを選んで語る「アドリブ大喜利」形式で進められた。
エヌビディア井﨑氏が語る「物理現象データ」4つの取得手段
エヌビディアの井﨑氏は、ChatGPTがなぜここまで賢くなったのかという問いから切り出した。「言語モデルは、さまざまな文章を学習して『この単語の次に来る確率が高い単語は何か』を学ぶものです。それを大量に学習させたら、あれほど賢くなってしまった。データを増やしたら想定以上の変化が起きた、というのが実情です」(井﨑氏)
裏を返せば、フィジカルAIもデータを大量に投入すれば想像以上の変化が起こり得る。問題は、物理現象のデータが世の中にほとんどないことだ。井﨑氏は、その取得手段を4つに整理した。
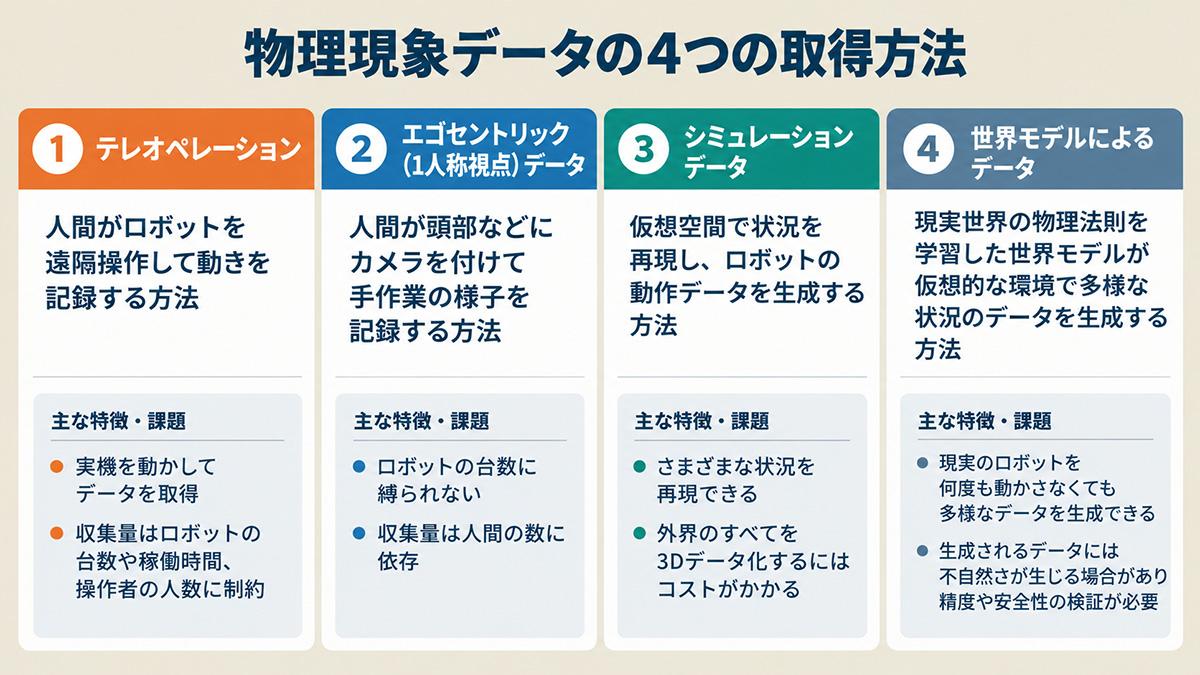
エヌビディア井﨑氏が語った物理現象のデータを取得するための4つの手段
(本文を基に編集部作成)
1つ目はテレオペレーション。人間がロボットを遠隔操作して動きを記録する方法だ。ただし、実機を動かしてデータを集める必要があるため、収集量はロボットの台数や稼働時間、操作者の人数に制約される。
2つ目はエゴセントリック(1人称視点)データで、人間が頭部などにカメラを付けて手作業を記録する。ロボットの台数には縛られないが、今度は人間の数に依存する。
3つ目はシミュレーションデータ。仮想空間で状況を再現するが、外界のすべてを3Dデータ化するにはコストがかかりすぎる。
そこで注目されているのが、4つ目の世界モデルによるデータだ。世界モデルとは、現実世界の物体の動きや位置関係などを学習し、ある行動によって周囲の状況がどう変化するかを予測・生成するAIモデルだ。現実のロボットを何度も動かさなくても、仮想的な環境で多様な状況を作り出せるため、学習データ不足を補う技術として期待されている。
「世界モデルは物理を理解したモデルなので、ある条件を与えると、30秒後の世界を物理的に正しい形で自動的に生成してくれます。これによってデータをどんどん増産でき、フィジカルAIを賢くするデータが生まれるのです」(井﨑氏)
もっとも、世界モデルが生成するデータは、現実の物理現象を常に正確に再現できるわけではない。生成結果には物体の動きや形状などに不自然さが生じる場合もあり、実際のロボットの学習や制御に利用するには、データの精度や安全性の検証が欠かせない。
一方、世界モデルの研究開発は国内外で進んでおり、エヌビディアも世界モデル「Cosmos」を開発している。馬渕氏が「エヌビディアはフィジカルAI時代のOSを丸ごと押さえにいく勢いでは?」と水を向けると、井﨑氏は「ツールやソフトウェアは基本的に無償で提供しています。そこで儲けようとは考えておらず、AIの進化をどう加速できるかに力を注いでいます」と応じた。
注目は「世界モデル」、日本が勝負できる「意外な領域」
建築家の豊田氏は、2027年に向けたキーワードとなる世界モデルについて、「今はあらゆる種類や性質の違うものを区別せずにひとまとめに、いわゆる十把一絡げ(じっぱひとからげ)にされている状態」だと指摘する。
「テキストには、コンピューターで検索や分析ができるように整理されたデータベースであるコーパスがあります。しかし実空間では、建築や都市の静的なデータですら、BIMなどはあってもテキストに比べればずっと少ない。人や車の動きといった動的データはさらに少なく、たとえば『誰かが殴りかかってきたときにどう逃げたか』のような関係性のデータはもっとありません。一口に世界モデルと言っても、それを技術的に記述するところには、まだ誰も到達していないのです」(豊田氏)
だからこそ日本にも余地がある、と豊田氏は見る。日本にエヌビディアのような会社はなく、OpenAIやアンソロピックのような企業が今後生まれることも期待しにくい。
だが、世界を記述するいくつかのレイヤーについて、精度の高いデータを蓄積し、体系化していく仕事は「むしろ製造業やものづくりの会社の方が得意な可能性がある」というのが理由だ。
たとえば、日本の製造業は、製品の設計や加工、品質管理などを通じて、物体の形状や動き、材料の特性といった物理現象を精密に捉え、データとして記録・管理する技術を培ってきた。こうした強みは、現実世界をAIが理解できる形で記述し、体系化する世界モデルの開発にも生かせる可能性がある。
ただし、そこで問題になるのが時間だ。中国企業が大量の資金と人海戦術で物理データを取りに来ている中で、残された時間は少ないと豊田氏は話す。
「本当に分岐点にある年だと思います。今やらないと間に合わないのではないかと、大学で研究していても冷や汗をかいています」(豊田氏) 【次ページ】東大が研究する「空間そのものがAIになる」未来
フィジカルAIのおすすめコンテンツ
関連タグ
タグをフォローすると最新情報が表示されます
あなたの投稿

PR
PR
PR
