
- 会員限定
- 2026/10/16 03:38 掲載
マイクロソフト、基盤モデル「MAI-Base-2」の事前学習完了 総2.8兆パラメーターのMoE


米マイクロソフトは10月15日(米国時間)、AI部門が自社開発の基盤モデル「MAI-Base-2」の事前学習を完了したと発表した。総パラメーター2.8兆、アクティブ800億のMoE構成で、DeepSeekのモデルより事前学習の計算効率が4~12倍高いと主張する。現在はポストトレーニング中で、重みはFoundry経由で提供する方針という。
(出典:Microsoft AI)
学習にはGPU「GB200」1万6000基を使い、2026年8月から9月にかけて38日間で実施した。学習データは50兆トークンで、うち18%を画像など視覚データが占める。画像を読み取る専用のエンコーダーを持たない構成で、最初から視覚と言語をまとめて学習した。ウェブデータの知識は2026年3月までという。
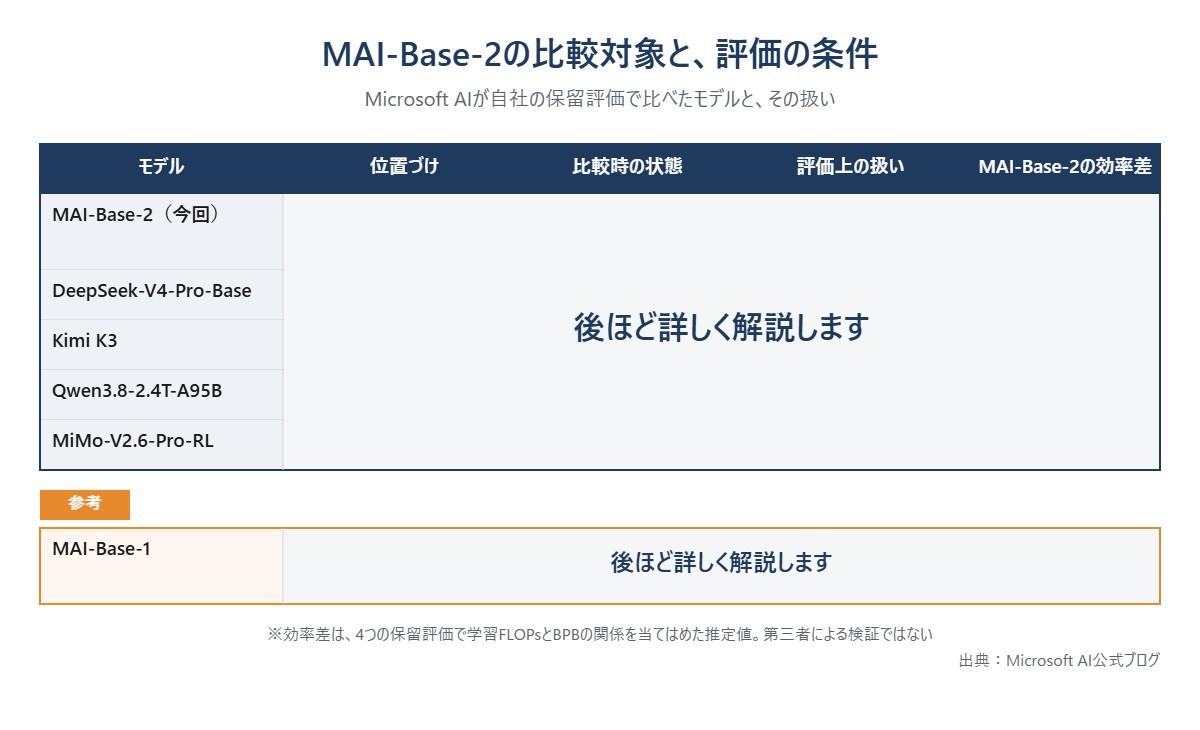
Microsoft AIは、保留評価でテストしたオープンウェイトモデルのすべてを上回ると主張する。最も高性能なオープンウェイトの基盤モデルとするDeepSeekの「DeepSeek-V4-Pro-Base」と比べ、事前学習の計算量あたりの効率は4~12倍といい、浮いた計算量をより大きなモデルの学習に振り向けたと説明する。学習データの規模は、前モデルの「MAI-Base-1」から約36%増えた。
同社は、学習データは自然由来のデータで、他のモデルからの蒸留は含まないと説明する。データの出どころを説明できることから、モデルの重みを「Foundry」を通じて信頼できるパートナーにライセンス提供できるとしている。一般提供の時期や価格は明らかにしていない。
MAI-Base-2は、6月に発表した推論モデルMAI-Thinking-1の土台となったMAI-Base-1の後継にあたる。同社はMAI-Base-2を、次世代モデル群の基盤と位置づけている。
では、Microsoft AIが打ち出した「DeepSeekの4~12倍」という効率は、いったい何と何を比べた数字なのか。ブログには、比較相手に付けられた但し書きと、MoEを全層に広げられた理由、そして学習データから見つかった不具合の話が記されている。
(出典:Microsoft AI公式ブログをもとに作成)
この記事の続き >>
・「4~12倍」は直接対決ではない、推定の中身
・DeepSeekほか3モデルに付いた但し書きの数々
・MoE全層化とMuon、効率を生んだ実装の裏側
・「4~12倍」は直接対決ではない、推定の中身
・DeepSeekほか3モデルに付いた但し書きの数々
・MoE全層化とMuon、効率を生んだ実装の裏側
今すぐビジネス+IT会員に
ご登録ください。
すべて無料!今日から使える、
仕事に役立つ情報満載!
-
ここでしか見られない
2万本超のオリジナル記事・動画・資料が見放題!
-
完全無料
登録料・月額料なし、完全無料で使い放題!
-
トレンドを聞いて学ぶ
年間1000本超の厳選セミナーに参加し放題!
-
興味関心のみ厳選
トピック(タグ)をフォローして自動収集!
AI・生成AIのおすすめコンテンツ
Googleで見つけやすく

共有する
-
0
-
0
-
0
-
0
-
0
関連タグ
タグをフォローすると最新情報が表示されます
AI・生成AIの関連コンテンツ
あなたの投稿

PR
PR
PR
