
- 会員限定
- 2026/10/18 15:21 掲載
中国人民大学、ツール障害に強いAIエージェント訓練手法を公開 8Bで5ベンチ平均58.6


中国人民大学などの研究チームは10月13日、ツールの異常応答やユーザーの訂正を受けても自力で立て直せるAIエージェントの訓練手法「Agent-Reflex」を発表した。Qwen3-8Bを土台に、長期のツール利用を測る5つのベンチマークの平均で58.6を記録した。コードとモデルも公開した。
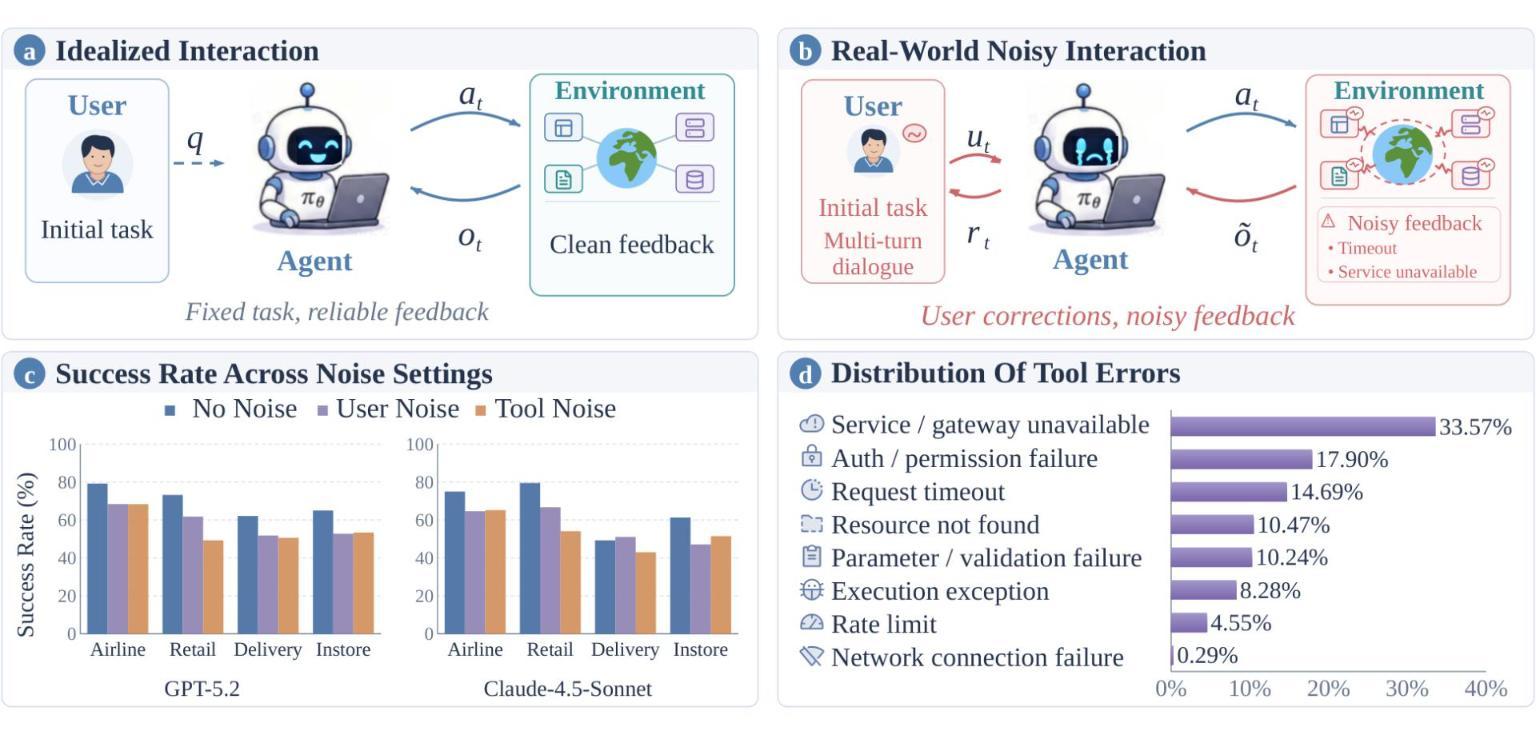
(出典:中国人民大学ほか)
実運用のエージェントは、MCP(Model Context Protocol)で接続したツールがタイムアウトやエラーを返したり、ユーザーが途中で口を挟んで誤りを正したりする状況に置かれる。ところが既存の訓練環境は、安定した応答と最小限のユーザー介入を前提にしていると、論文は指摘する。
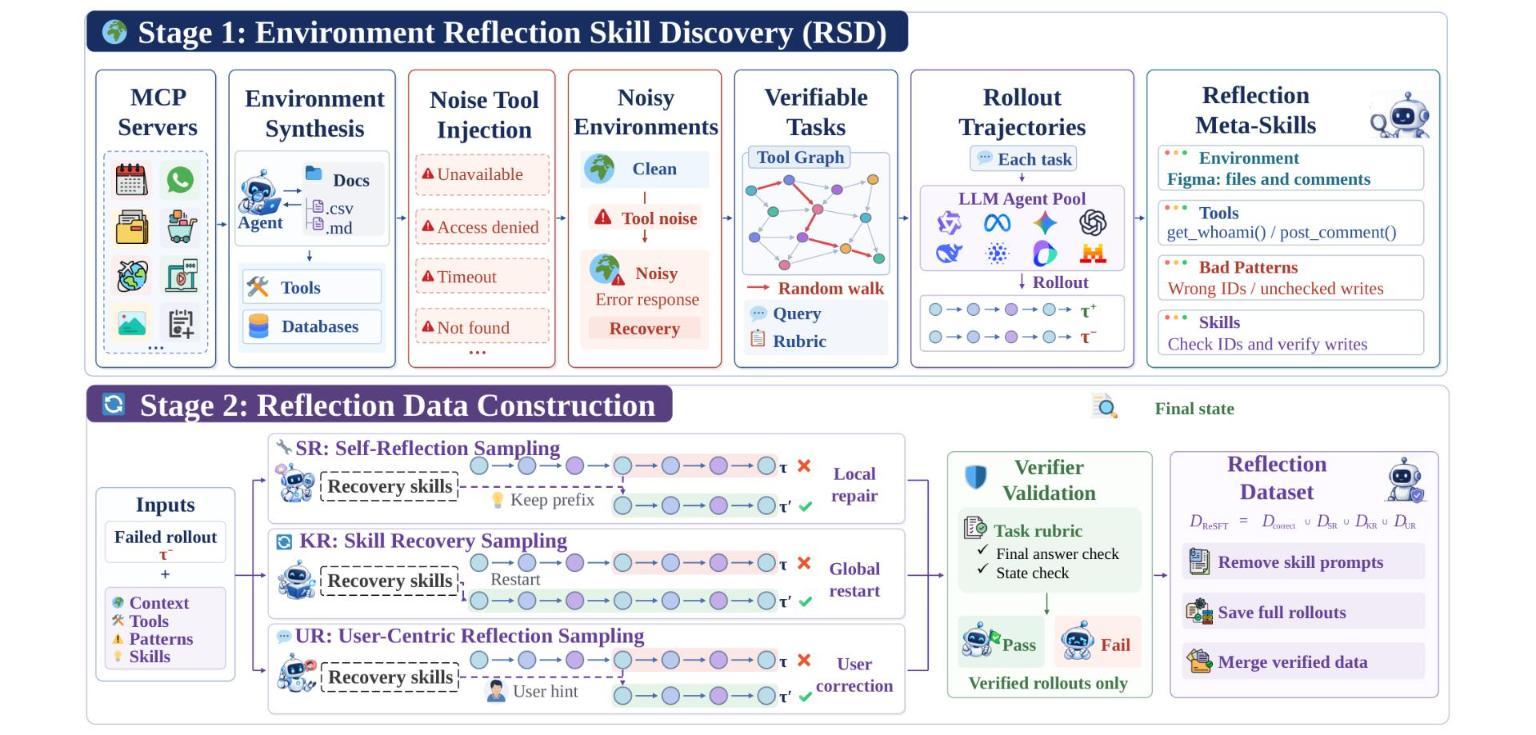
(出典:arXiv論文)
訓練は3段階で進む。第1段階の「環境反省スキル発見(RSD)」では、利用の多いMCPサーバ仕様557件から、データベースと実行可能なツールを備えた環境を自動で構築し、実際のエラー応答に基づく失敗を確率的に混ぜる。9つの公開ベンチマークで記録したツール応答17万7,700件のうち2万4,510件がエラーで、これを8系統に分類したという。複数のLLMが同じタスクを解いた成功例と失敗例の組から、再利用できる「反省メタスキル」1,170件を抽出した。
第2段階の「反省SFT(ReSFT)」は、各スキルを自己反省、計画のやり直し、ユーザーの訂正への対応という3種類の教師データに変換し、教師あり微調整で取り込む。第3段階の「ORPO」は、ノイズ入りの環境での強化学習に、スキルを与えた状態で同じトークンを再評価する蒸留を組み合わせる。スキルは訓練時にだけ使い、実運用のエージェントはスキルなしで動く。
Qwen3-8Bを土台にした「Agent-Reflex-8B」は、長期のツール利用を測る5つのベンチマークの平均で58.6、ノイズ下の性能を測るAgentNoiseBenchで29.1を記録した。基盤のQwen3-8B(40.2、12.3)を大きく上回った。
コードとスキルライブラリはMITライセンスで、GitHubで公開されている。ReSFT用の学習データ5万4,663件の軌跡と、Agent-Reflex-8Bのチェックポイントも、Hugging Faceで入手できる。
では、この8Bモデルの成績は、巨大モデルやフロンティアモデルと比べて、どこまで通用するのか。論文の表には、パラメーター数で桁違いのモデルとの意外な逆転と、ノイズ下で浮かぶ大きな差、そして比較の読み方を左右する但し書きがある。
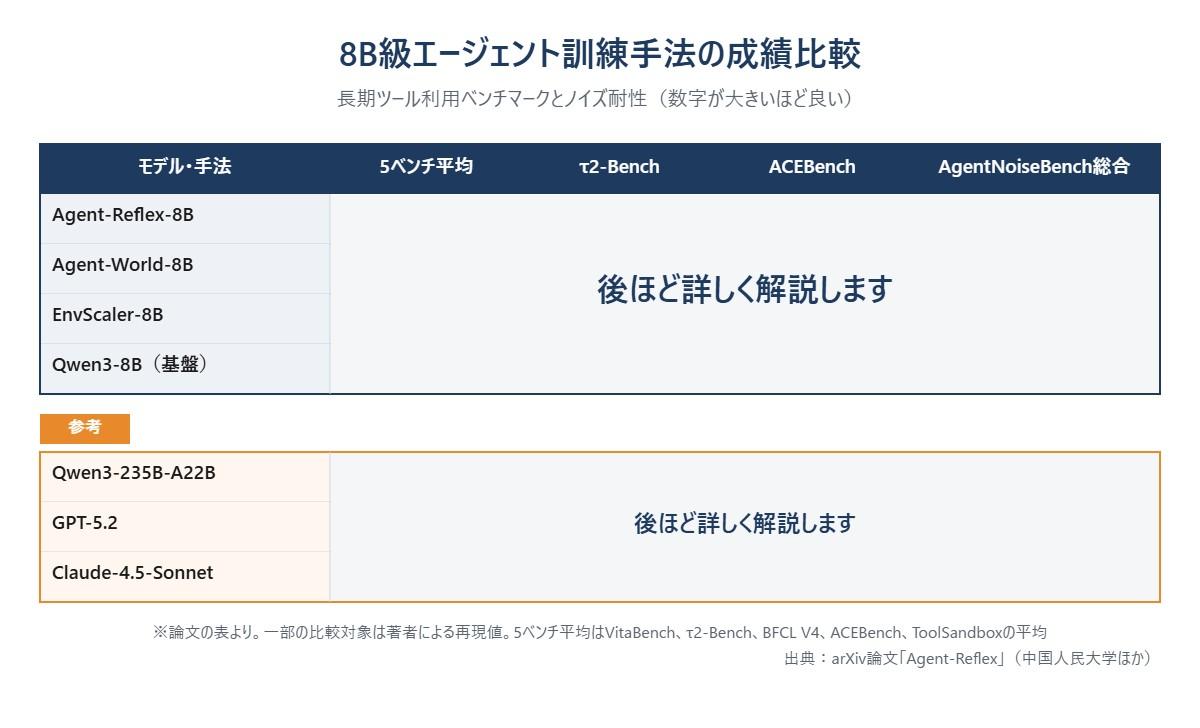
(出典:arXiv論文をもとに作成)
この記事の続き >>
・5ベンチ平均で上回った巨大モデルと、その中身
・ノイズ下でGPT-5.2とClaudeに残る大きな差
・比較表の「再現値」が示す、数字の読み方
・5ベンチ平均で上回った巨大モデルと、その中身
・ノイズ下でGPT-5.2とClaudeに残る大きな差
・比較表の「再現値」が示す、数字の読み方
今すぐビジネス+IT会員に
ご登録ください。
すべて無料!今日から使える、
仕事に役立つ情報満載!
-
ここでしか見られない
2万本超のオリジナル記事・動画・資料が見放題!
-
完全無料
登録料・月額料なし、完全無料で使い放題!
-
トレンドを聞いて学ぶ
年間1000本超の厳選セミナーに参加し放題!
-
興味関心のみ厳選
トピック(タグ)をフォローして自動収集!
AI・生成AIのおすすめコンテンツ
Googleで見つけやすく

共有する
-
0
-
0
-
0
-
0
-
0
関連タグ
タグをフォローすると最新情報が表示されます
AI・生成AIの関連コンテンツ
あなたの投稿

PR
PR
PR
