
- 会員限定
- 2026/10/20 08:43 掲載
米メタ、AI訓練基盤「Prometheus」の内幕を公開 数十万GPUが稼働、目標は100万基


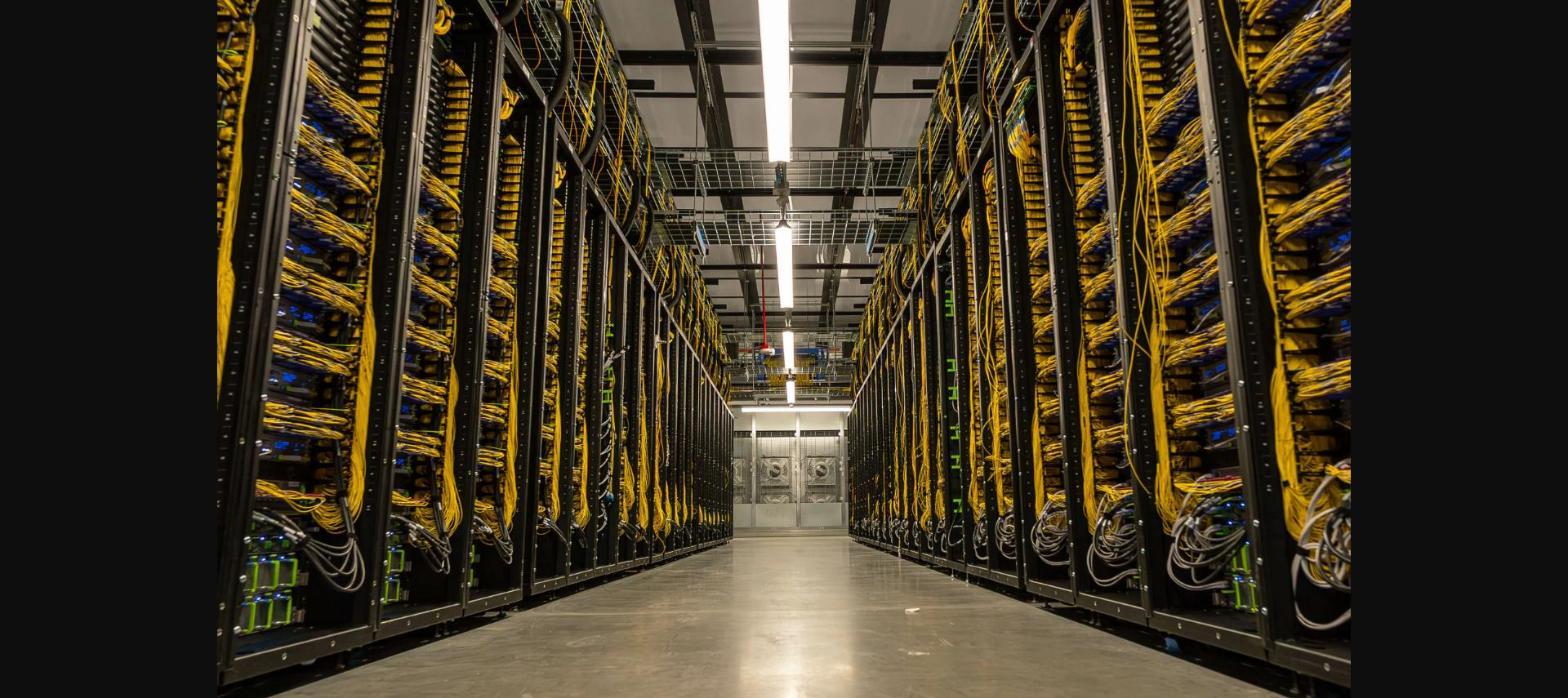
米メタは10月19日、オハイオ州に構築するギガワット級のAI訓練基盤「Prometheus(プロメテウス)」の内幕を公表した。数十万基のGPUが稼働中で、最終的に約100万基への拡大を目指す。「Muse Wonder」の訓練に使われ、事前学習で85%超、強化学習で90%超のgoodputを達成した。NVIDIAのGB200とGB300に加え、Vera Rubinも近く導入する。
(出典:米メタ)
Prometheusは、今月発表した新たな最上位AIモデル「Muse Wonder」を含む、Museシリーズの訓練に使われた。メタによると、2年前のニューアルバニーは通常のWebトラフィックを処理するデータセンターだった。ハードウェアやネットワーク、建物設計の進化を取り入れて、最先端モデルの訓練拠点に作り替えたという。
第1フェーズはすでに完成している。従来型とAI最適化型のデータセンター棟、急速展開型の施設を光ファイバーで結び、1台のマシンのように動かしている。
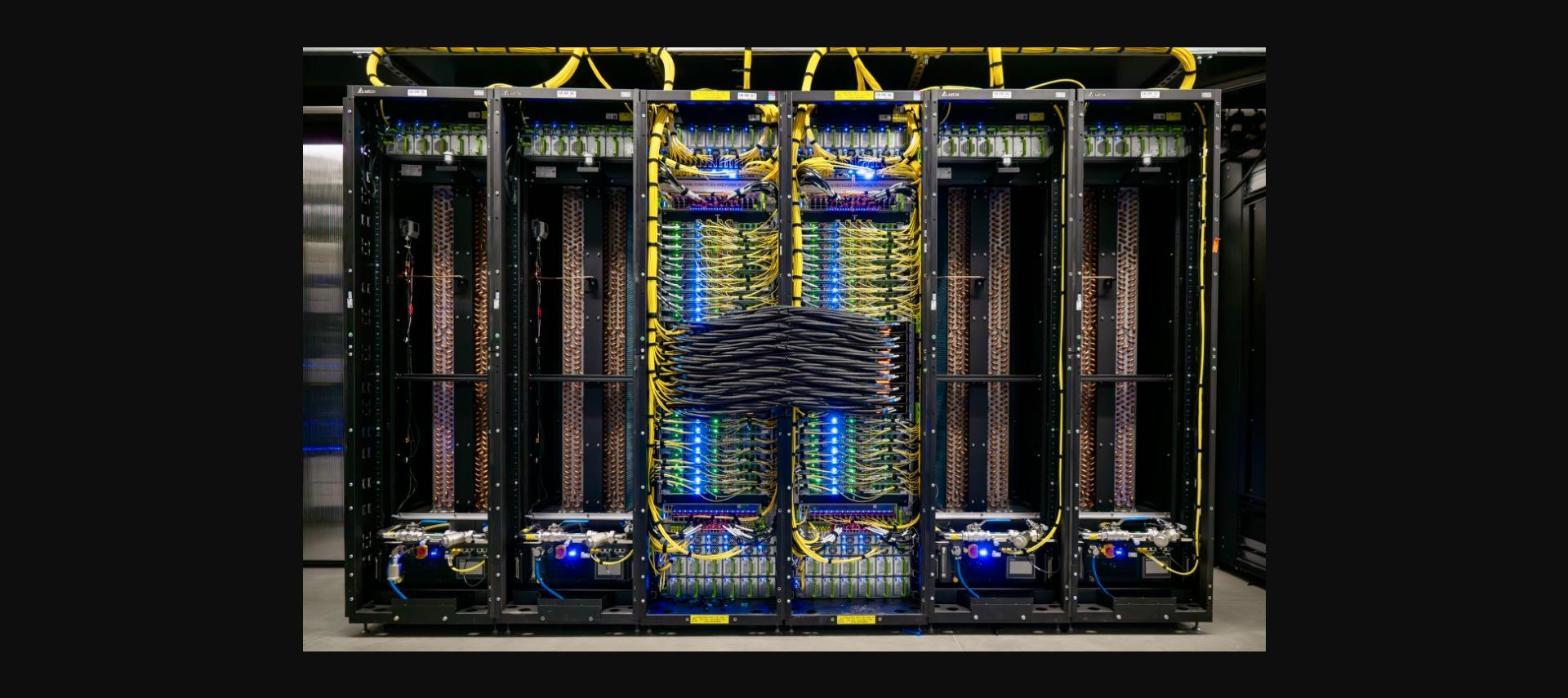
Prometheusで使われるNVIDIA GB200 NVL72のラック
(出典:米メタ)
GPUはNVIDIA製で、現在は2つのプラットフォームを導入している。GB200 NVL72を使う「Catalina」と、GB300 NVL72を使う「Clemente」だ。第3のプラットフォームとして、Vera Rubin NVL72ベースの「San Miguel」が近く加わる。
安定性の指標も示した。Muse Wonderの訓練では、事前学習で85%超、強化学習(RL)で90%超のgoodput(有効に使えた訓練時間の割合)を達成したという。平均中断間隔(MTBI)は当初約4万7000GPU時間で、その後のファームウェア修正などで5万4000GPU時間超に伸びた。
ネットワークは、GPU同士を直接つなぐ専用のイーサネット網で構成する。建物内の1つのファブリックは最大2万736基のGPUを結び、建物間を結ぶ集約網は2km~100km超に及ぶ。全体では光ファイバーが数百万マイル、スイッチが数万台、光トランシーバーが数百万個規模になるという。
電力面では、数万基のGPUが同期して動くため、クラスター内で30~40%の負荷変動が生じる。メタは、電力の上限が近づくとGPUの電力上限を徐々に下げる管理基盤「Dynamo Dimmer」と、ラック内の電池やキャパシター、施設全体の蓄電システムでこれを吸収している。
冷却は、空気を併用するモジュール型の液冷と、新設したAI最適化棟の施設液冷を使い分ける。
では、100万基を目指すメタは、なぜ演算性能よりも「壊れ方」の設計に力を注いだのか。背景には、ラックの大型化で膨らんだ故障の影響範囲と、1年で中断を激減させた具体策がある。
Prometheusを支えるNVIDIAの3世代
(出典:米メタの公表値をもとに作成)
この記事の続き >>
・GPU1基の不調が72基に波及する、NVL72ならではの難所
・学習に使うのは72基中64基だけ、残る8基を予備にする理由
・ザッカーバーグ氏が2025年に語った「26年稼働」と、5GW級Hyperionへの布石
・GPU1基の不調が72基に波及する、NVL72ならではの難所
・学習に使うのは72基中64基だけ、残る8基を予備にする理由
・ザッカーバーグ氏が2025年に語った「26年稼働」と、5GW級Hyperionへの布石
今すぐビジネス+IT会員に
ご登録ください。
すべて無料!今日から使える、
仕事に役立つ情報満載!
-
ここでしか見られない
2万本超のオリジナル記事・動画・資料が見放題!
-
完全無料
登録料・月額料なし、完全無料で使い放題!
-
トレンドを聞いて学ぶ
年間1000本超の厳選セミナーに参加し放題!
-
興味関心のみ厳選
トピック(タグ)をフォローして自動収集!
AI・生成AIのおすすめコンテンツ
Googleで見つけやすく

共有する
-
0
-
0
-
0
-
0
-
0
関連タグ
タグをフォローすると最新情報が表示されます
AI・生成AIの関連コンテンツ
あなたの投稿

PR
PR
PR
