
- 会員限定
- 2026/10/20 23:22 掲載
ディープシーク、推論基盤「DeepInfer」をApache-2.0で公開 NVIDIAとAscendに対応


ディープシークは10月20日、自社の大規模サービスを支える推論フレームワーク「DeepInfer」をオープンソースで公開した。ライセンスはApache-2.0で、DeepSeek-V4.1-Flashに対応する。NVIDIAのSM100 GPUとファーウェイのAscend 950 NPUの両方で動く。ただしオフライン推論までで、KVキャッシュ系や負荷分散は含まれない。
(出典:ディープシーク)
対応モデルはDeepSeek-V4.1-Flashで、初期設定のチェックポイントには、10月17日に公開したDeepSeek-V4.1-Flash-1017を使う。初回の実行時にHugging Faceのキャッシュへダウンロードする仕組みだ。
対応するハードウェアは、NVIDIAのSM100世代のGPUと、ファーウェイのAI半導体(NPU)「Ascend 950」の2系統。ディープシークは9月30日にも、Ascend向けの基盤ソフトウェア群をオープンソースで公開している。
搭載する主な機能は、アテンション部分のデータ並列(Attention DP)、MoE(専門家混合)モデルのエキスパート並列(EP)とその負荷分散を担うEPLB、非同期スケジューリング、バッチ不変推論、決定論的サンプリング、構造化出力など。ビルドにはLinux、GCC 13.0以上、Python 3.12が必要で、NVIDIA環境ではCUDA 13、Ascend環境ではCANN 9.2を使う。
ただし、今回公開したのはオフライン推論までだ。完全な推論サービスに必要な要素として、KVキャッシュのシステム、Prefill(入力処理)とDecode(出力生成)の分離、データ並列レプリカ間の負荷分散の3点を挙げており、いずれも今回のリリースには含まれない。Prefill/Decodeの分離については、必要なエンジン機能の大半は実装済みだという。
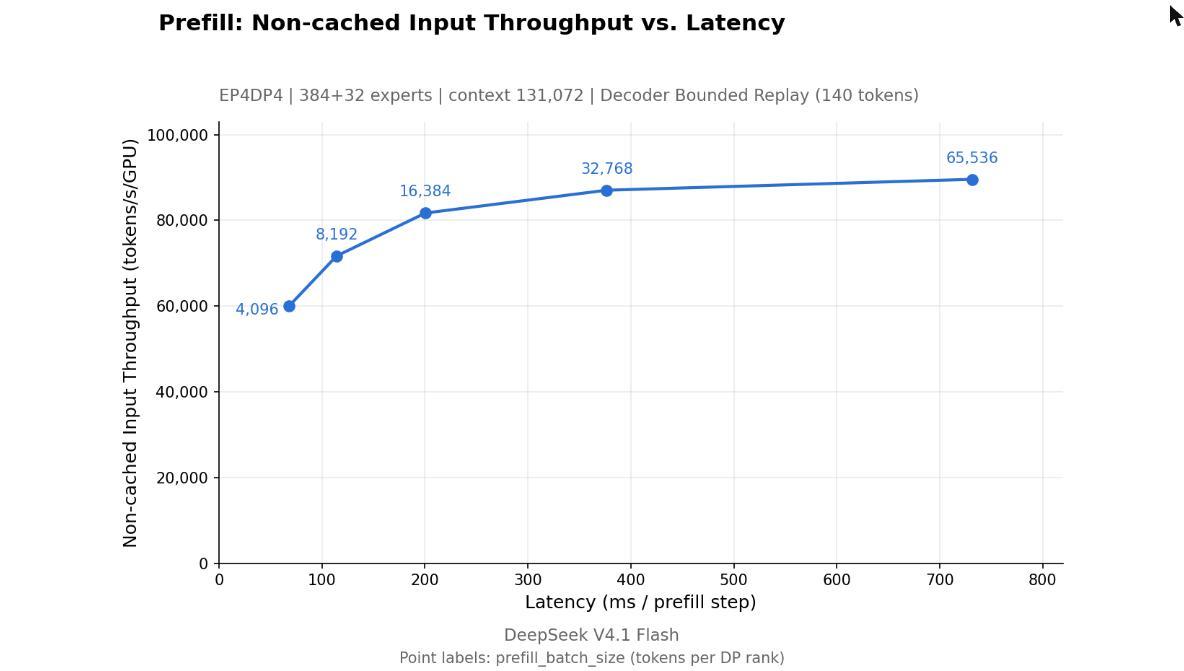
DeepInferのPrefill性能(非キャッシュ入力のスループットとレイテンシー)
(出典:ディープシーク)
性能の測定は、Prefillで4基、Decodeで64基のSM100 GPUを使い、それぞれ1つのスケールアップドメイン内で行ったとしている。開発の経緯について、ディープシークは当初、主にvLLMを土台に構築し、SGLangとTensorRT-LLMからも着想を得たと説明している。
では、ディープシークが公開しなかった部分には何があり、公開した部分だけでどこまで自社運用できるのか。公式の技術文書には、同社の運用規模を示す数字と、導入側が見落としやすい最小構成の条件が記されている。
DeepInferで公開された部品と公開されていない部品
(出典:ディープシークの公式文書をもとに作成)
この記事の続き >>
・1日155兆トークン、GPU1時間あたり38ドルという運用の実力
・公開されなかったKVキャッシュ基盤と、100PiB級の専用ストレージ
・効率運用の最小単位は128GPU、公開版だけでは足りない部分
・1日155兆トークン、GPU1時間あたり38ドルという運用の実力
・公開されなかったKVキャッシュ基盤と、100PiB級の専用ストレージ
・効率運用の最小単位は128GPU、公開版だけでは足りない部分
今すぐビジネス+IT会員に
ご登録ください。
すべて無料!今日から使える、
仕事に役立つ情報満載!
-
ここでしか見られない
2万本超のオリジナル記事・動画・資料が見放題!
-
完全無料
登録料・月額料なし、完全無料で使い放題!
-
トレンドを聞いて学ぶ
年間1000本超の厳選セミナーに参加し放題!
-
興味関心のみ厳選
トピック(タグ)をフォローして自動収集!
AI・生成AIのおすすめコンテンツ
Googleで見つけやすく

共有する
-
0
-
0
-
0
-
0
-
0
関連タグ
タグをフォローすると最新情報が表示されます
AI・生成AIの関連コンテンツ
あなたの投稿

PR
PR
PR
