
- 会員限定
- 2026/11/17 19:15 掲載
【Transformerを超えた】Metaが放つ次世代AIアーキテクチャ「Memory Mosaics」とは?
Transformerの限界を打ち破る連想メモリの仕組み


LLM(大規模言語モデル)のデファクトのニューラルネットワークアーキテクチャである「Transformer」の限界を突破する新アーキテクチャ「Memory Mosaics」が脚光を浴びている。Metaを中心とした研究チームが発表したこのモデルは、予測タスクを自動分割する連想メモリを採用し、膨大なデータを力任せに処理する従来手法とは一線を画す。最新の「Memory Mosaics v2」は圧倒的な学習効率を記録しており、未知のタスクへの適応力を実証している。
トランスフォーマーの構造的課題を解決する連想メモリネットワーク
2017年にGoogleの研究者が発表した論文「Attention Is All You Need」で紹介された、大規模言語モデルの根幹を成すアーキテクチャ「Transformer」は登場以来AIの進化を牽引してきた。ChatGPTやClaude、Geminiなど現在のLLMのベースとなっているニューラルネットワークアーキテクチャと言える。一方で、文脈が長くなるにつれて計算コストが二次関数的に膨れ上がる点や、未知のタスクに対応するために途方もないデータ量を反復学習させなければならないという構造的な課題を抱えている。モデル内部の自己注意機構においてあらゆる情報が複雑に絡み合い、AIがどのような論理で回答を導き出しているのかという解釈性も長年の障壁だった。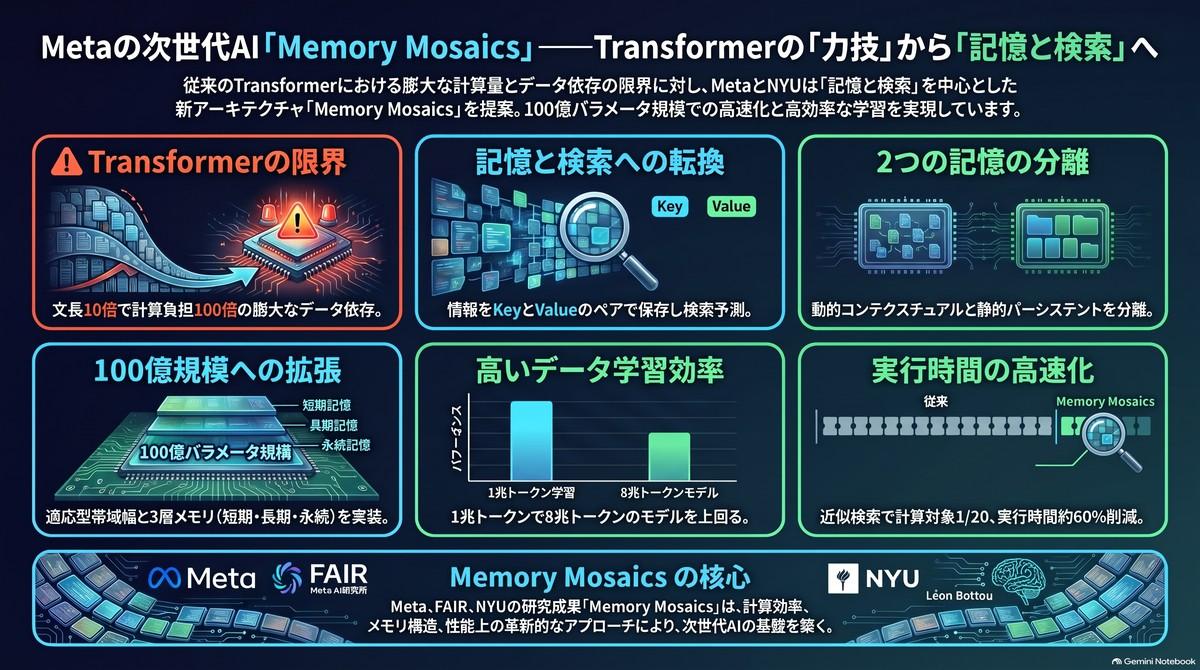
【図版付き記事はこちら】Transformerを超える新アーキテクチャ「Memory Mosaics v2」とは?(図版:ビジネス+IT)
このネットワークは学習の過程で複雑な全体タスクを自動的に小さな独立したサブタスクへと分割し、個別のメモリユニットに割り当てる。研究チームはこの自律的な分割メカニズムを予測的もつれ解消と呼んでいる。複数の月が異なる周期で惑星を周回する軌道を予測する実験では、単一のメモリが全体の配置パターンを完全に記憶するのを待つことなく、「Memory Mosaics」はそれぞれの月の軌道を個別のメモリユニットに学習させた。最小限の観測期間で系全体の正確な動きを把握することに成功している。
このアプローチは位置エンコーディングを必要とせず、推論時にはタスクの要求に応じてメモリユニットを動的に削減できる。アーキテクチャが本質的に持つ帰納バイアスにより、少ないパラメータ数でも高い一般化能力を発揮する。Transformerが抱える計算資源の浪費を抑えつつ、AIの推論過程そのものを透明化する可能性を秘めている。この理論的な裏付けをもとに、研究チームはアーキテクチャを100億パラメータ規模にまで巨大化させた最新版を実データ環境に投入した。そこで明らかになったのは従来の定石を根本から覆す驚異的なデータ効率の実態であり、次ページではその詳細な実証結果とオープンワールドAIに向けた影響を掘り下げる。
1兆トークンの学習で8兆トークンモデルを凌駕する実用化への歩み
初期の理論実証に続き、研究チームは100億パラメータ規模に拡張し、1兆トークンの実データで学習させたMemory Mosaics v2を発表した。現実世界の大規模環境でも学習の安定性と長文脈処理能力を担保するため、記憶エントリの増加に合わせて情報の平滑化度合いを調整する適応型ガウスカーネル帯域幅といった新たな技術が導入された。
今すぐビジネス+IT会員に
ご登録ください。


新規登録キャンペーン実施中
Amazonギフト券5,000円分
毎月抽選20名様にプレゼント
対象:期間中、上の「今すぐ登録(無料)」ボタンから
プレミアム会員にご登録いただいた方
すべて無料!今日から使える、
仕事に役立つ情報満載!
-
ここでしか見られない
2万本超のオリジナル記事・動画・資料が見放題!
-
完全無料
登録料・月額料なし、完全無料で使い放題!
-
トレンドを聞いて学ぶ
年間1000本超の厳選セミナーに参加し放題!
-
興味関心のみ厳選
トピック(タグ)をフォローして自動収集!
AI・生成AIのおすすめコンテンツ
Googleで見つけやすく

共有する
-
0
-
0
-
0
-
0
-
0
関連タグ
タグをフォローすると最新情報が表示されます
AI・生成AIの関連コンテンツ
あなたの投稿

PR
PR
PR
