
- 会員限定
- 2026/11/22 03:00 掲載
OpenAI、AIの思考過程を盗む攻撃の成功率を0.2%へ低減 GPT-6.2で多層防御を導入
不正蒸留対策を強化、利用規約改定で企業実務にも影響


OpenAIは2026年11月20日、最新モデルであるGPT-6.2 AstraとGPT-6.2 Solにおいて、AI内部の思考過程を不正に抜き取る攻撃への防御を大幅に強化したと発表した。社内試験では攻撃の成功率が従来の54.0%から0.2%へと激減している。技術的な防壁の強化に加え、同日には利用ポリシーの改定も施行されており、AIを活用する企業の開発現場にも新たな対応が求められている。
内部推論の抽出成功率が54.0%から0.2%に低下、二層の防御網を構築
OpenAIが対策を強化した対象は、モデルが最終回答を導き出す前に内部で生成する思考の途中経過、すなわち内部推論である。この過程は通常、利用者には要約のみが示され、生データは非公開とされている。ある高度なAIの出力を使って別のAIを学習させる手法は蒸留と呼ばれるが、OpenAIは許可なく出力や内部推論を集め、競合モデルの構築に転用する行為を敵対的蒸留と位置づけている。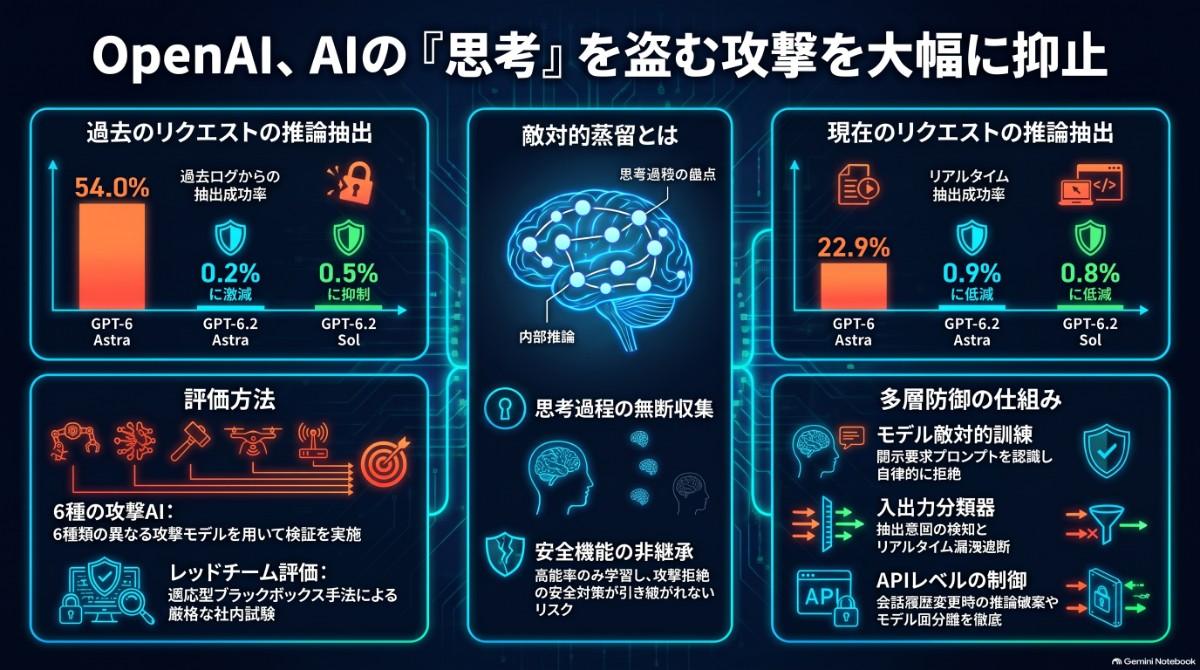
【図版付き記事はこちら】OpenAI、AIの思考過程を盗む攻撃の成功率を0.2%へ低減 GPT-6.2で多層防御を導入(画像:ビジネス+IT)
防御の仕組みは、個別のやり取りを守る層と組織的な不正を監視する層の二段階で構築された。個別の対策では、抽出の試みを拒否させる訓練をモデルに施したうえで、入力と出力の双方を専用の分類器で監視する。応答を少しずつ返すストリーミング出力や外部ツールを呼び出す際のデータも検査対象とし、漏洩の疑いがあれば遮断する設計だ。API側でも、内部推論をその会話履歴に紐づけ、過去のメッセージを書き換えた場合は後続の推論データを自動破棄する制御を導入した。保護策の弱い旧世代モデルが新モデルの内部推論を読み取る経路も塞いでいる。
一方、組織的な活動に対しては複数アカウントの挙動を横断的に解析し、2026年は週あたり数千から数万件規模のアカウントに制限や停止措置を講じた。ただし、措置対象の累計数や国別の内訳について公式は発表していない。OpenAIが最終回答だけでなく思考過程の保護に踏み込んだ背景には、単なる知的財産の防衛を超えた安全保障上の懸念と、企業のAI運用ルールを書き換える新たな動きがある。
安全対策なき能力移転の脅威、改定ポリシーが日本企業に突きつける実務課題
OpenAIが内部推論の流出を強く警戒する理由は、元のモデルに組み込まれた安全対策が引き継がれないまま、高度な能力だけが別モデルへ移転する点にある。サイバー攻撃や危険な生物研究への協力を拒否する仕組みを持たないAIが誕生するリスクを同社は指摘している。社内の検証実験では、プログラミングや防御的なサイバーセキュリティの課題において、最終回答の要約のみで学習させたモデルよりも、完全な内部推論で学習させたモデルの方が高い性能を示した。思考の途中経過には最終回答に表れない詳細な手順が含まれており、それが別のAIの技能を大きく底上げする材料となる。
今すぐビジネス+IT会員に
ご登録ください。


新規登録キャンペーン実施中
Amazonギフト券5,000円分
毎月抽選20名様にプレゼント
対象:期間中、上の「今すぐ登録(無料)」ボタンから
プレミアム会員にご登録いただいた方
すべて無料!今日から使える、
仕事に役立つ情報満載!
-
ここでしか見られない
2万本超のオリジナル記事・動画・資料が見放題!
-
完全無料
登録料・月額料なし、完全無料で使い放題!
-
トレンドを聞いて学ぶ
年間1000本超の厳選セミナーに参加し放題!
-
興味関心のみ厳選
トピック(タグ)をフォローして自動収集!
AIセキュリティのおすすめコンテンツ
Googleで見つけやすく

共有する
-
0
-
0
-
0
-
0
-
0
関連タグ
タグをフォローすると最新情報が表示されます
あなたの投稿

PR
PR
PR
