
- 会員限定
- 2026/10/29 02:16 掲載
GitHub、Claude Codeに2点差の「半額」AI投入…「Copilot Fusion」の仕組みとは?


GitHubは10月28日、AIコーディング支援「GitHub Copilot」で、タスクごとに最適なAIモデルを自動で選び、組み合わせる「Copilot Fusion」の一般提供を開始した。Maxはコーディングエージェントの指数でClaude Code(Opus 5.5 Max)に2点差まで迫り、1タスクあたりのAPI費用は約半分という。管理者向けの制御機能も備える。
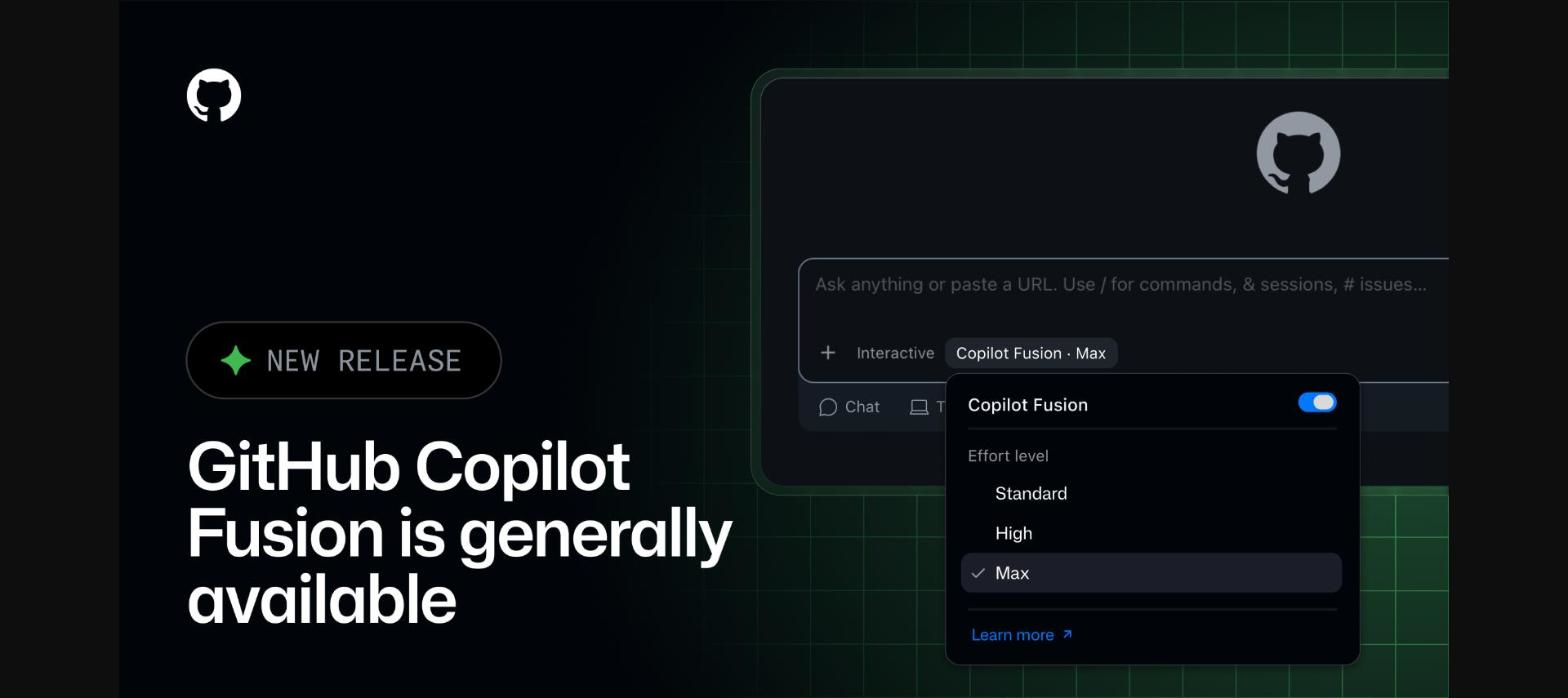
(出典:GitHub)
努力レベルは3段階ある。「Standard」は日常的なコーディング向けの汎用的なモデル、「High」は難しいタスクや深い推論向けの高性能なモデル、「Max」は最も要求の厳しいタスクや複雑な推論向けの最高性能のモデルを優先して使う。
モデルの組み合わせ方は3つのワークフローで、1つのモデルが直接解く「Single」、効率的なモデルが下書きし、品質チェックで受け入れるか強いモデルに引き上げるかを決める「Cascade」、1つのモデルの下書きを別のモデルがレビューし、元のモデルが修正する「Critique」だ。
GitHubによると、Artificial AnalysisのCoding Agent IndexでCopilot Fusion Maxは60点を記録し、Claude CodeとOpus 5.5 Maxの組み合わせとの差は2点以内だった。1タスクあたりの平均API費用は約半分、使用トークン数も約半分で、所要時間は約40%短いという。
管理者向けには、Copilot Fusionが使えるモデルを企業・組織のモデルポリシーで有効なものに限る制御がある。企業の管理者は、Copilot Fusionが選ぶモデルを確認し、特定のモデルだけをFusionで無効にすることもできる。Enterprise managed settingsを使えば、努力レベルを問わずCopilot Fusionを既定のモデルに設定できる。
導入企業のAT&Tでプリンシパル・ソフトウェア・エンジニアを務めるハリ・ポクレル氏は、Copilot Fusion Standardがタスクに合ったモデルを自動で選ぶことで、AT&T全体のトークン効率が高まったと述べている。
課金は、Copilot Fusionが使った各モデルの標準単価で行う。期間限定で、有料のCopilotプランの利用者はモデル費用が30%割引になる。すべてのCopilotプランで、Visual Studio Code、GitHub Copilotアプリ、GitHub Copilot CLI、JetBrains系IDEから使える。対応クライアントは今後追加するという。
では、「半額で2点差」という数字は、どこまで額面どおりに受け取っていいのか。第三者の評価機関が測ったタスク当たりの実額と、Claude Codeに及ばなかった指標、そして競合の同種システムとの勝負が、数字の裏にある。
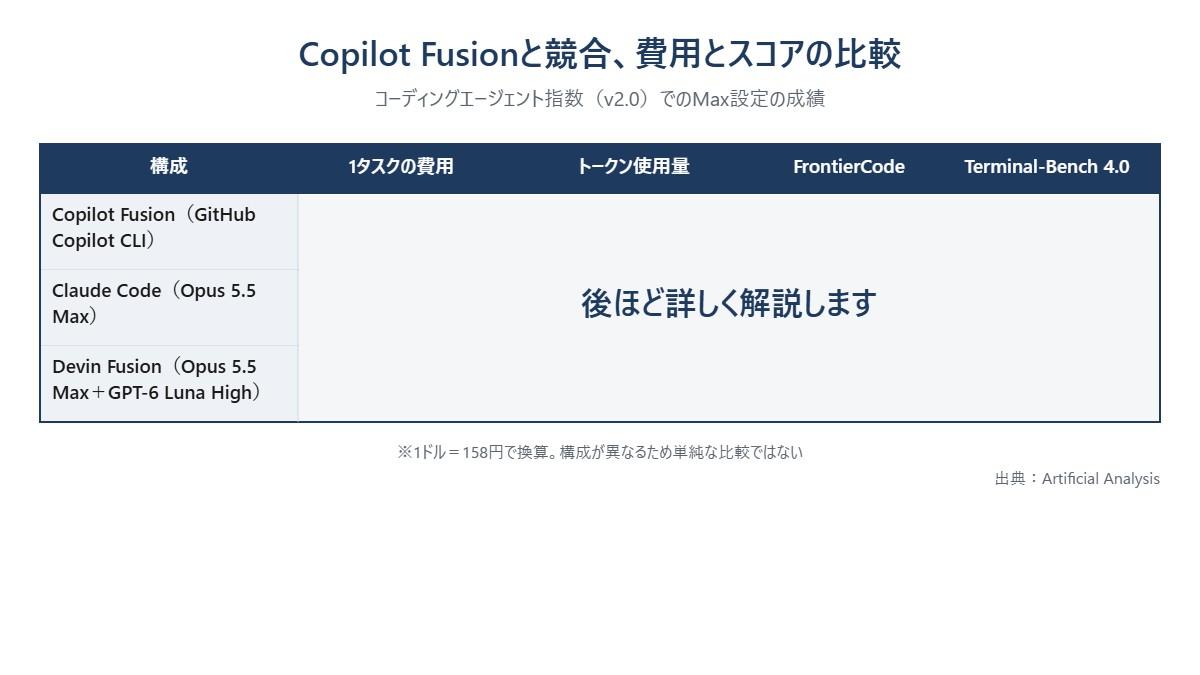
Copilot Fusionと競合、費用とスコアの比較
(出典:Artificial Analysisの発表をもとに作成)
この記事の続き >>
・Claude Codeに負けた指標はどれか、ベンチマーク別の成績表
・競合「Devin Fusion」との費用とスコアの勝負の行方
・研究プレビューから一般提供へ、HydraFusionの進化の中身
・Claude Codeに負けた指標はどれか、ベンチマーク別の成績表
・競合「Devin Fusion」との費用とスコアの勝負の行方
・研究プレビューから一般提供へ、HydraFusionの進化の中身
今すぐビジネス+IT会員に
ご登録ください。
今だけ毎月当たる!ずっと無料の会員登録キャンペーン

ビジネス+ITプレミアム会員(無料)に登録すると
抽選で毎月20名様に
Amazonギフト券 5,000円分 当たる!
プレミアム会員に登録する(ずっと無料) キャンペーン詳細・応募条件を見る※この表示が出ている方は自動的にキャンペーンにエントリーされます。特典送付時にビジネス+ITプレミアム会員を継続し、メールマガジン購読設定をオンにしていることが条件です。その他の条件は詳細をご覧ください
すべて無料!今日から使える、
仕事に役立つ情報満載!
-
ここでしか見られない
2万本超のオリジナル記事・動画・資料が見放題!
-
完全無料
登録料・月額料なし、完全無料で使い放題!
-
トレンドを聞いて学ぶ
年間1000本超の厳選セミナーに参加し放題!
-
興味関心のみ厳選
トピック(タグ)をフォローして自動収集!
システム開発ツール・開発言語のおすすめコンテンツ
Googleで見つけやすく

共有する
-
0
-
0
-
0
-
0
-
0
関連タグ
タグをフォローすると最新情報が表示されます
システム開発ツール・開発言語の関連コンテンツ
あなたの投稿

PR
PR
PR
