
- 会員限定
- 2026/11/18 17:25 掲載
米マイクロソフトが大規模障害の検証報告発表、Outlook復旧のみ長期化した理由は?
潜在バグと負荷急増が連鎖、メール復旧を阻んだ構造的な壁


2026年11月12日に発生したMicrosoft 365の世界的な大規模障害について、米マイクロソフトは暫定的な事後検証報告を公表した。3つの要因が連鎖してネットワークゲートウェイ全体に波及したことが原因であることがわかった。各サービスが順次回復する中、Outlookが利用するExchange Onlineの復旧だけが異例の長時間を要した。その背景には電子メール特有のアーキテクチャが生み出す構造的な課題が存在していた。
3つの要因が連鎖して応答不能に陥ったゲートウェイ基盤と機能しなかった防波堤
11月12日に発生したMicrosoft 365の大規模障害は、複数のサービスへの接続を中継するネットワークゲートウェイで起きた。マイクロソフト幹部のチャールズ・ラマンナ氏が11月16日に公表した暫定的な原因分析によると、単一のエラーではなく、3つの要因が重なることで障害が連鎖的に拡大した。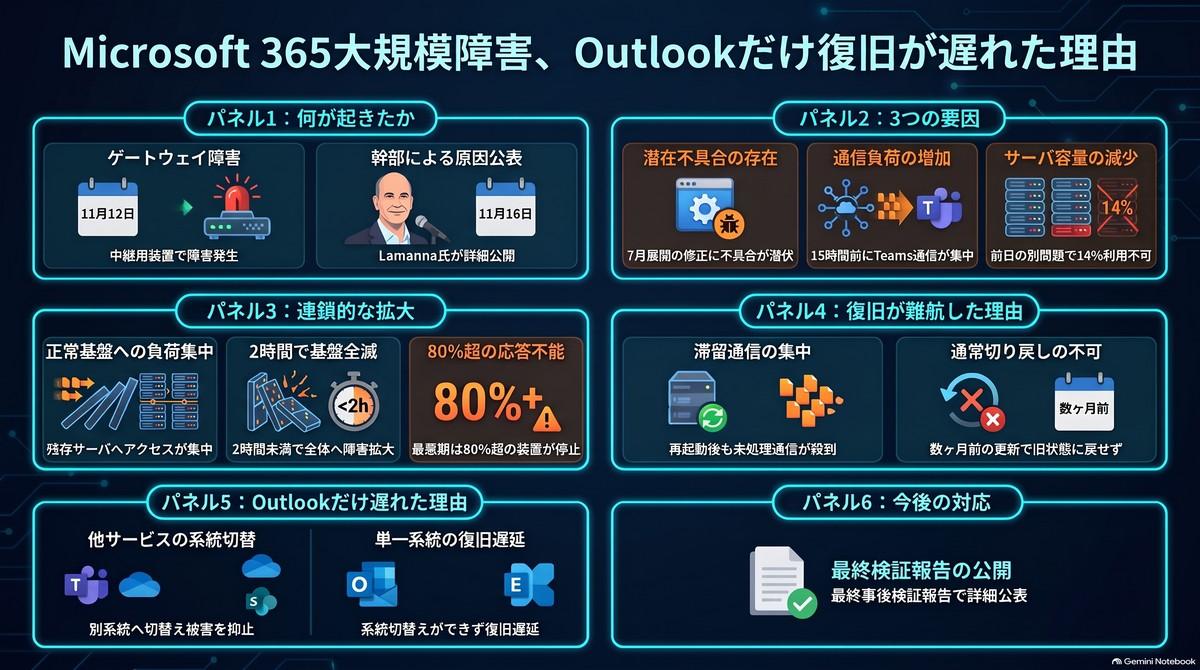
【図版付き記事はこちら】Microsoft 365大規模障害、Outlookだけ復旧が遅れた理由とは?3つの連鎖要因(画像:ビジネス+IT)
2つ目の要因は、通信負荷の増加である。障害発生の約15時間前、サービスの継続性を確保するための通常の運用として、Teamsの通信が別系統のゲートウェイから主要なゲートウェイに切り替わった。これにより、ベースラインとなる通信トラフィックが大きく変化し、負荷が増加した。
3つ目の要因として、前日に発生した別の問題によってゲートウェイのサーバ容量の約14%が利用できない状態になっていたことが挙げられる。容量の低下自体は許容範囲内であったが、Teamsからの通信負荷増加と重なったことで、7月から潜んでいた修正プログラムの不具合が一気に表面化した。
一部のサーバが応答を停止すると、システムは通信を残りの正常なサーバへ自動的に振り分けた。しかし処理能力を超えた負荷が集中したことで、残るサーバも次々とクラッシュしていった。本来は基盤を複数の区画に分けて障害の波及を防ぐ隔壁の仕組みが存在するが、別の問題によって機能不全を起こしており、障害は2時間足らずで基盤全体に広がり、最悪の時点ではサーバの80%超が応答しなくなった。
マイクロソフトの対応によりTeamsやSharePointなどは別系統のゲートウェイに切り替えることで順次回復に向かった。しかし、Outlookの基盤であるExchange Onlineの復旧にはさらなる長時間を要している。次ページでは、Outlookだけが長時間の停止を強いられた技術的な理由と、復旧作業を阻んだ電子メールインフラ特有の高い壁について詳解する。
電子メール特有の構造とサンダリング・ハード現象が阻んだ早期復旧
TeamsやSharePointといったWebベースのアプリケーションは、特定のゲートウェイがダウンした際に通信を別の健全なネットワークへ即座に迂回させる柔軟なアーキテクチャを備えている。対照的に、Exchange Onlineは多数のクライアントとの間で状態を保持したセッションを大量に維持している。そのため、障害発生時に影響下の主要ゲートウェイから別の代替インフラへアクセスを大規模に退避させることが技術的に不可能であった。
今すぐビジネス+IT会員に
ご登録ください。


新規登録キャンペーン実施中
Amazonギフト券5,000円分
毎月抽選20名様にプレゼント
対象:期間中、上の「今すぐ登録(無料)」ボタンから
プレミアム会員にご登録いただいた方
すべて無料!今日から使える、
仕事に役立つ情報満載!
-
ここでしか見られない
2万本超のオリジナル記事・動画・資料が見放題!
-
完全無料
登録料・月額料なし、完全無料で使い放題!
-
トレンドを聞いて学ぶ
年間1000本超の厳選セミナーに参加し放題!
-
興味関心のみ厳選
トピック(タグ)をフォローして自動収集!
IT運用管理全般のおすすめコンテンツ
Googleで見つけやすく

共有する
-
0
-
0
-
0
-
0
-
0
関連タグ
タグをフォローすると最新情報が表示されます
IT運用管理全般の関連コンテンツ
あなたの投稿

PR
PR
PR
