- 会員限定
- 2026/10/04 10:23 掲載
AIが作業中の「記憶」を自ら編集、メタとワシントン大学が新方式「CLM」を論文で発表


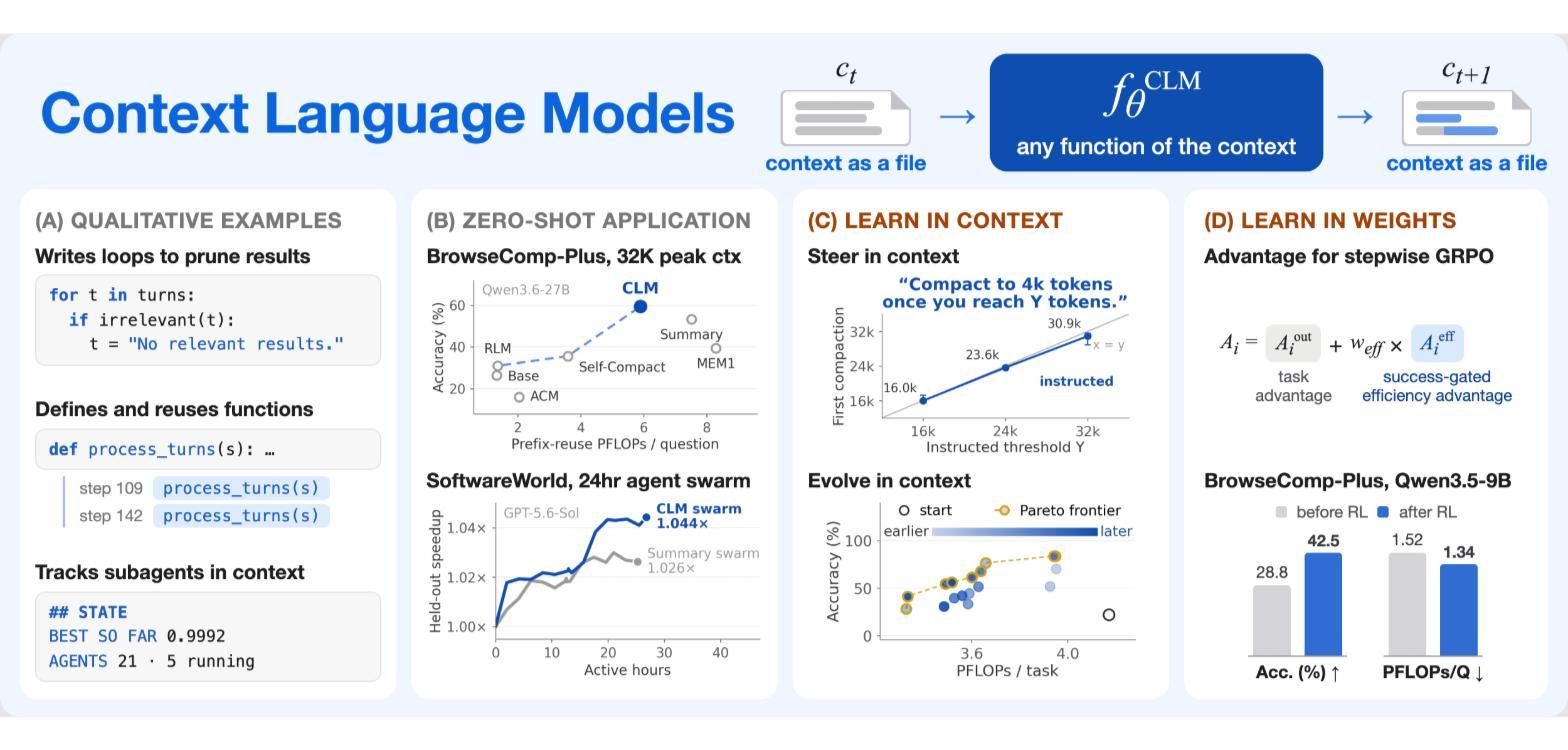
米ワシントン大学やメタ・スーパーインテリジェンス・ラボなどの研究チームは、AIモデルが作業中に保持する情報(コンテキスト)を自ら書き換えて管理する「Context Language Models(CLM)」を論文で発表した。人手設計の枠組みを使う従来方式より、深層調査などの長期タスクで高い精度と少ない計算量を両立したという。
(出典:arXiv)
CLMは、このコンテキストを「ファイル」として扱う。モデルは新たに生成した文章を追記できるほか、Bashを使ってファイルを自由に編集でき、変更は次のターンの実際のコンテキストにすぐ反映される。従来は、人手で設計した枠組み(ハーネス)による要約や退避、検索が中心だった。研究チームは、モデルに管理を任せるほうが高い成績を示したとしている。
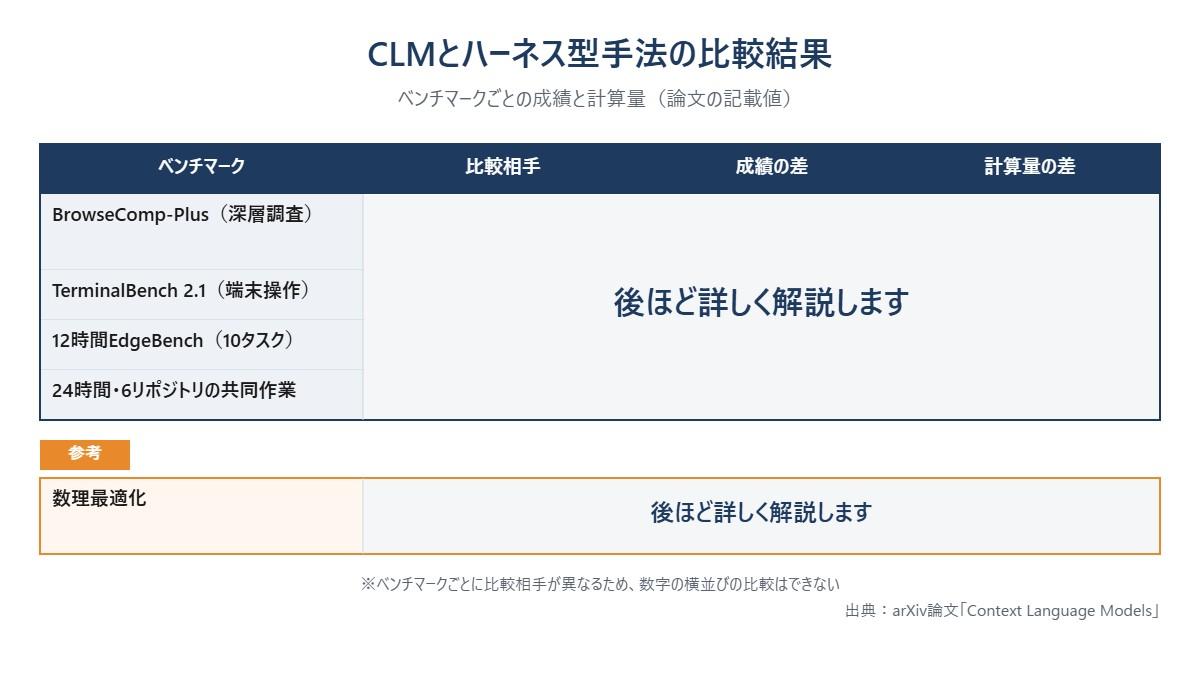
評価では、Qwen3.6-27BやGPT5.6-Solといった既存モデルにゼロショットで適用した。深層調査ベンチマークのBrowseComp-Plusでは、最も強いベースラインより精度が11.4%高く、計算量の指標であるprefix-reuse FLOPsは21.5%少なかった。端末操作のTerminalBench 2.1では精度が同等で、計算量は29.5%減った。
12時間規模のEdgeBench(10タスクの部分集合)では、Codex型の要約よりスコアが5%高く、計算量は59%少ない。6つのリポジトリを扱う24時間のエージェント群のタスクでは、同じ計算量で高速化の幅が65%大きかった。
数理最適化では、進化型のハーネスであるOpenEvolveを、Heilbronn問題で最大16.8%、円詰め込み問題で3.0%上回ったという。
強化学習も試した。Qwen3.5-9BをBrowseComp-Plusで鍛えた結果、成績は47.6%向上し、計算量は12%減ったという。
あわせて、キャッシュ済みの計算結果を再利用して再計算を減らす「Suffix Cache Reuse」も開発した。推論サーバのSGLangを標準で使う場合と比べ、成績を保ったまま、サーバ側の計算量を35%減らせたとしている。
では、AIが自分の「記憶」を自由に書き換えられるようになると、現場では何が変わり、何が危うくなるのか。背景には、論文自身が認める新たな攻撃面と、モデルが自力で編み出した文脈管理の手口がある。
(出典:arXiv論文「Context Language Models」をもとに作成)
この記事の続き >>
・AIが勝手に編み出した、人間が設計していない「記憶術」
・一言の指示とスキル文書の自己進化がもたらす効果
・書き換え自由な記憶が開く、プロンプトインジェクションの抜け穴
・AIが勝手に編み出した、人間が設計していない「記憶術」
・一言の指示とスキル文書の自己進化がもたらす効果
・書き換え自由な記憶が開く、プロンプトインジェクションの抜け穴
今すぐビジネス+IT会員に
ご登録ください。
すべて無料!今日から使える、
仕事に役立つ情報満載!
-
ここでしか見られない
2万本超のオリジナル記事・動画・資料が見放題!
-
完全無料
登録料・月額料なし、完全無料で使い放題!
-
トレンドを聞いて学ぶ
年間1000本超の厳選セミナーに参加し放題!
-
興味関心のみ厳選
トピック(タグ)をフォローして自動収集!
AI・生成AIのおすすめコンテンツ
Googleで見つけやすく
共有する
-
0
-
0
-
0
-
0
-
0
関連タグ
タグをフォローすると最新情報が表示されます
AI・生成AIの関連コンテンツ
あなたの投稿

PR
PR
PR