- 2026/09/26 07:10 掲載
ベンチマーク高得点でも「仕事ができるAI」とは限らない…国内企業に学ぶ新選定術(2/2)


国内事例に見る「自社の業務に必要な性能」
では、実務に合うモデルをどう見極めるか。まず決めたいのは、仕事ごとの合格条件だ。たとえば議事録なら、決定事項や担当者、期限を原文どおりに残せること。社内文書への質問回答なら、根拠を示し、資料にないことを勝手に補わないこと。流暢さだけでは合否を決められない。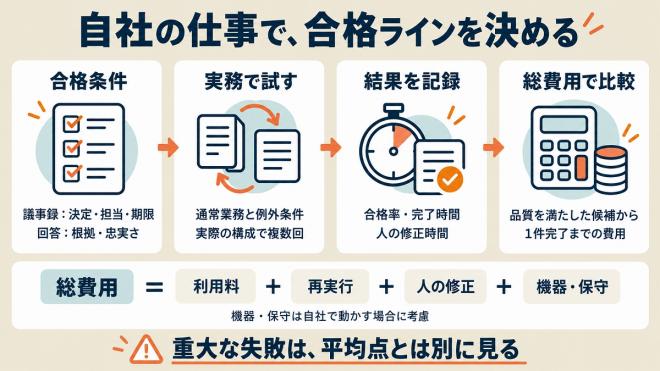
(本文をもとに生成AIで作成)
国内のtokimoaが7月17日に公開した評価レポートは、架空企業の合成データを使い、議事録要約40問と文書を参照する回答57問を評価した。要約の忠実度や引用の正確さに加え、計算に使う数値の精度を下げてモデルを軽くする量子化や、出力上限などの設定でも結果が変わったと報告している。
同レポートは各構成1回の実行で、最上位クラウドモデルとの直接比較も含まない。読み取れるのは、特定モデルの絶対的な優位性ではなく、実際に使う構成で業務に近い課題を測る意義だ。モデル名が同じでも、動かし方まで同じとは限らない。
自社で試すなら、普段の仕事に加え、情報が欠けた依頼や例外的な条件も用意する。その上で複数回試し、品質を満たした割合、完了までの時間、人が修正した時間を記録する。まれな失敗でも影響が大きい業務は、平均点とは別に失敗の中身を見る必要がある。
品質を満たす候補がそろってから、費用を比べる。利用料金が安くても、再実行や人の修正が増えれば割安とは限らない。比較単位は、依頼1回の料金より、仕事を1件完了させるための総費用だ。
小型モデルやローカルAIも、この手順で候補に入る。ただし、モデルの規模と実行場所は別の軸である。手元で動かすなら、機器や保守の費用も含めて合格条件を満たすかを確かめる。27Bで十分かどうかの答えは、業務と運用条件によって変わる。
ベンチマークの高得点は、選定を始める有力な材料になる。その先に必要なのは、自社の資料とツールを使い、必要な確認を経て、許容できる時間と費用で仕事を終えられるかの検証だ。最上位モデルを選ぶ場合も、小型モデルを選ぶ場合も、問われるのは同じこと。順位表の強さを、業務の成果に変えられるかである。
導入後のAI費用を1/10に落とした国内企業も
モデルを業務に合わせて選ぶ考え方を、組織の運用にどう組み込むか。日本トレカセンターの技術者が9月18日にZennで公開した全社導入の報告は、その具体例になる。
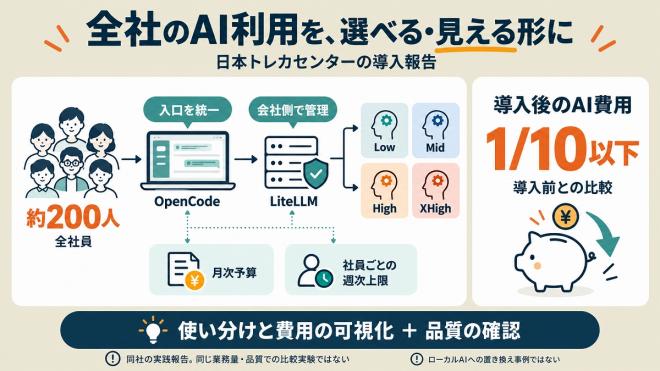
導入後のAI費用を1/10に落とした事例もある
報告によると、同社は約200人の全社員がAIを使う入口をOpenCodeにまとめ、複数のAI提供元への接続を仲介するLiteLLMを経由させた。モデルを会社側で管理し、月単位の予算と社員ごとの週次上限を設定。導入後のAI費用は、それ以前の1/10以下に収まったという。
社員向けの選択肢はLow、Mid、High、XHighの4段階に整理したとする。裏側のモデルは性能を見ながら調整でき、社員が手元の設定を変えずに利用できる仕組みだ。投稿者は、高価な最先端モデルを使い続ける状態を見直したことや、費用の可視化を削減理由に挙げている。
この数字は同社の実践報告であり、同じ品質の仕事を同じ量こなした比較実験ではない。ローカルAIへの置き換えで費用を削減した事例でもない。一方で、モデル選択を個人任せにせず、利用状況と費用を把握して調整する運用は具体的に示されている。
企業が取り入れる際は、予算だけでなく品質の確認も組み合わせたい。通常の仕事は合格条件を満たすモデルで処理し、難しい案件は別のモデルや人に引き継ぐ。ただし、細かく使い分けるほど管理や検証の手間も増えるため、分担による効果と合わせて評価する必要がある。
ベンチマークの高得点は、選定を始める有力な材料になる。その先に必要なのは、自社の資料とツールを使い、必要な確認を経て、許容できる時間と費用で仕事を終えられるかの検証だ。最上位モデルを選ぶ場合も、小型モデルを選ぶ場合も、問われるのは同じこと。順位表の強さを、業務の成果に変えられるかである。
(本文をもとに生成AIで作成)
報告によると、同社は約200人の全社員がAIを使う入口をOpenCodeにまとめ、複数のAI提供元への接続を仲介するLiteLLMを経由させた。モデルを会社側で管理し、月単位の予算と社員ごとの週次上限を設定。導入後のAI費用は、それ以前の1/10以下に収まったという。
社員向けの選択肢はLow、Mid、High、XHighの4段階に整理したとする。裏側のモデルは性能を見ながら調整でき、社員が手元の設定を変えずに利用できる仕組みだ。投稿者は、高価な最先端モデルを使い続ける状態を見直したことや、費用の可視化を削減理由に挙げている。
この数字は同社の実践報告であり、同じ品質の仕事を同じ量こなした比較実験ではない。ローカルAIへの置き換えで費用を削減した事例でもない。一方で、モデル選択を個人任せにせず、利用状況と費用を把握して調整する運用は具体的に示されている。
企業が取り入れる際は、予算だけでなく品質の確認も組み合わせたい。通常の仕事は合格条件を満たすモデルで処理し、難しい案件は別のモデルや人に引き継ぐ。ただし、細かく使い分けるほど管理や検証の手間も増えるため、分担による効果と合わせて評価する必要がある。
ベンチマークの高得点は、選定を始める有力な材料になる。その先に必要なのは、自社の資料とツールを使い、必要な確認を経て、許容できる時間と費用で仕事を終えられるかの検証だ。最上位モデルを選ぶ場合も、小型モデルを選ぶ場合も、問われるのは同じこと。順位表の強さを、業務の成果に変えられるかである。
Googleで見つけやすく
共有する
-
0
-
1
-
0
-
0
-
0
AI・生成AIのおすすめコンテンツ
関連タグ
タグをフォローすると最新情報が表示されます
AI・生成AIの関連コンテンツ
あなたの投稿

PR
PR
PR