- 2026/09/26 07:10 掲載
ベンチマーク高得点でも「仕事ができるAI」とは限らない…国内企業に学ぶ新選定術


最も賢いAIを選べば、仕事も速く終わるのか。とあるコミュニティで話題になったのが、ベンチマークで高得点のモデルへの不満と、27Bモデルで日常の用途は十分だとする声だ。異なる仕事で生まれた評価の逆転は、企業のAI選びにも問いを投げかける。確認や修正に人が追われれば、高得点でも期待した成果にはつながらないという。実際に国内で取り組んだ使い分け事例や、全社運用を見直して費用を削減した事例から「仕事ができるAI」の条件を考える。
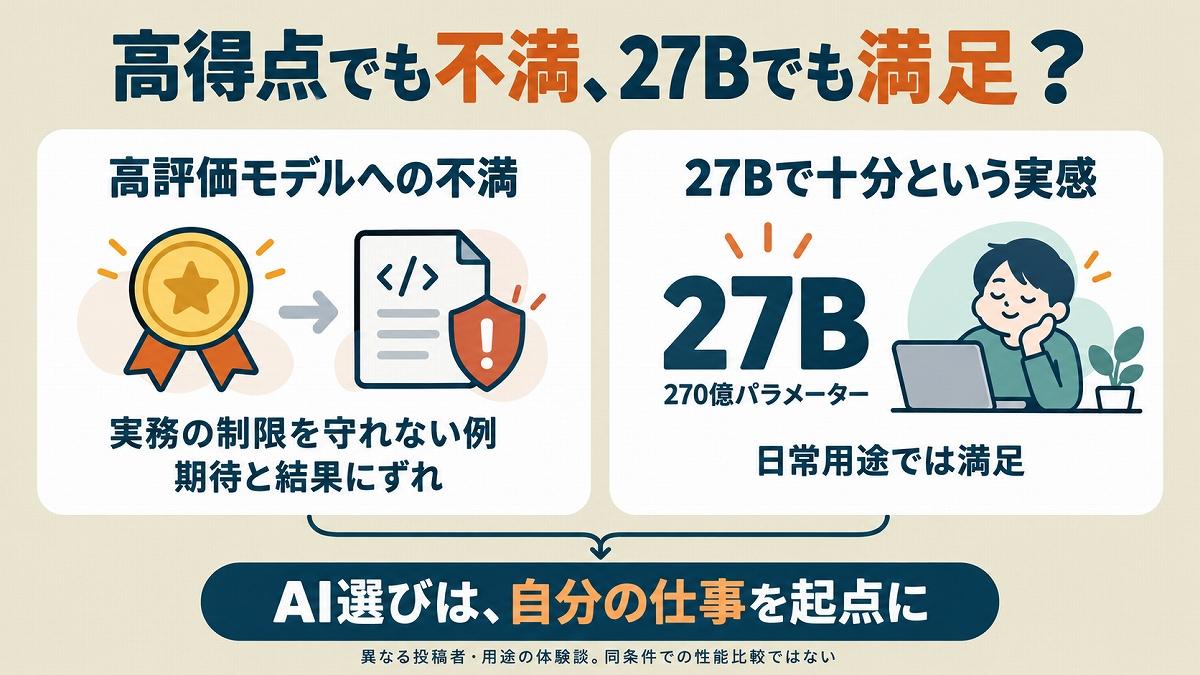
(本文をもとに生成AIで作成)
高得点でも不満、27Bでも満足するのはなぜか
高得点のAIを使っても、仕事では期待どおりに動かないようだ。9月23日、オンライン掲示板Redditに、AI選びの常識を問い直す対照的な体験談が相次いで投稿された。ある投稿者は、ベンチマークでの高評価に言及した上で、「MiMo-V2.6」を実務に近い作業で試した結果を報告。コードの変更を外部に送る操作に制限を設けるよう依頼したところ、出力されたコードに制限を回避できる問題があったという。コメント欄には同様の不満が寄せられる一方、少数の試行でモデル全体を評価することへの反論や、自分の用途では問題なく動くとの声も寄せられた。
別の投稿者は、Qwenのモデルを比較し、日常的な用途では27B、すなわち270億パラメーター規模のモデルで十分だとする使用感を紹介した。クラウドのAIを使う理由も、賢さより処理速度や、一度に扱える情報量になってきたという。
高い評価への期待が不満に変わり、手元で動くモデルが満足につながる。興味深い評価の逆転だ。ただし、両者は異なるタスクを試しており、同じ条件で性能が逆転したわけではない点に注意が必要で、むしろ、その違いに企業のAI選びを考えるヒントがあると言えそうだ。
難しい問題を解けることと、自分の仕事が滞りなく終わることは、どこまで重なるのか。日本の技術コミュニティでも、作業別のモデル分担や、費用を抑える全社運用が報告されている。
ベンチマークでは見えにくい実務の評価軸
性能評価のための共通試験であるベンチマークは、モデルの能力を比較する有力な手段だ。実際のソフトウェア開発に近い課題を測るものもあり、一律に机上の試験とは言えない。ただし、そこで扱う仕事や実行条件が、自社の業務と一致するとは限らない。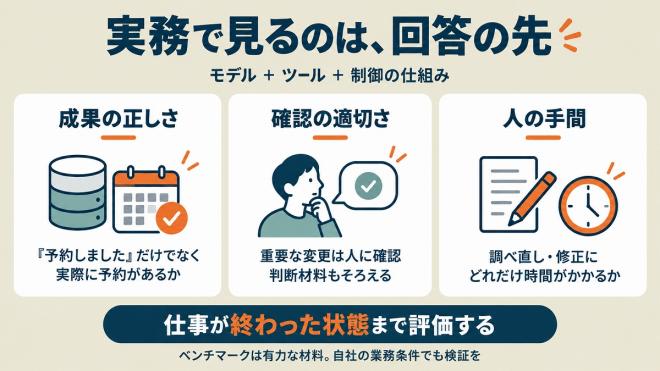
実務で見るべきはベンチマークではなく、回答の「先」にある
(本文をもとに生成AIで作成)
アンソロピックはAIエージェントの評価ガイドで、モデルと、それを動かすツールや制御の仕組みを合わせて評価すると説明している。また、AIが予約完了を伝えたかではなく、データベースに実際の予約が存在するかを成果として捉える例を示す。評価対象は、返答だけでなく実行後の状態だ。
人とのやり取りにも、実務ならではの差が表れる。9月23日にZennへ投稿されたClaudeとGPTの活用報告では、試験問題のデータ加工に使うモデルをOpus 5.5に替えたところ、過去の処理例を調べてから確認を求めるようになったという。投稿者は、問題やルールの処理をOpus 5.5、文章の仕上げをGPT-6 Solに任せ、正解の確定は公式資料を確認する自分が担ったとしている。
これは同条件で優劣を測った実験ではない。それでも、実務で評価する対象が、回答の正しさだけでなく、確認の手間や分担のしやすさにも及ぶことを示している。人が毎回調べ直す必要があるのか、判断材料がそろった状態で承認できるのか、その差は業務の進み具合を変えることになる。
もちろん、確認が少なければ優秀というわけでもない。重要な変更を無断で進めれば、後の修正負担が増えるからだ。企業が見るべきは、必要な確認を残しながら、成果物を完成させるまでにどれだけ人の手間がかかるかという視点なのである。 【次ページ】自社の仕事に必要な性能は、どこまでなのか
AI・生成AIのおすすめコンテンツ
関連タグ
タグをフォローすると最新情報が表示されます
AI・生成AIの関連コンテンツ
あなたの投稿

PR
PR
PR