
- 2026/10/26 07:10 掲載
Claude Codeで「失敗続き」は卒業…コードを“1行も読まない”アプリ開発「4原則」(2/3)



AIが「平気でウソをつく」根本原因はこれだ
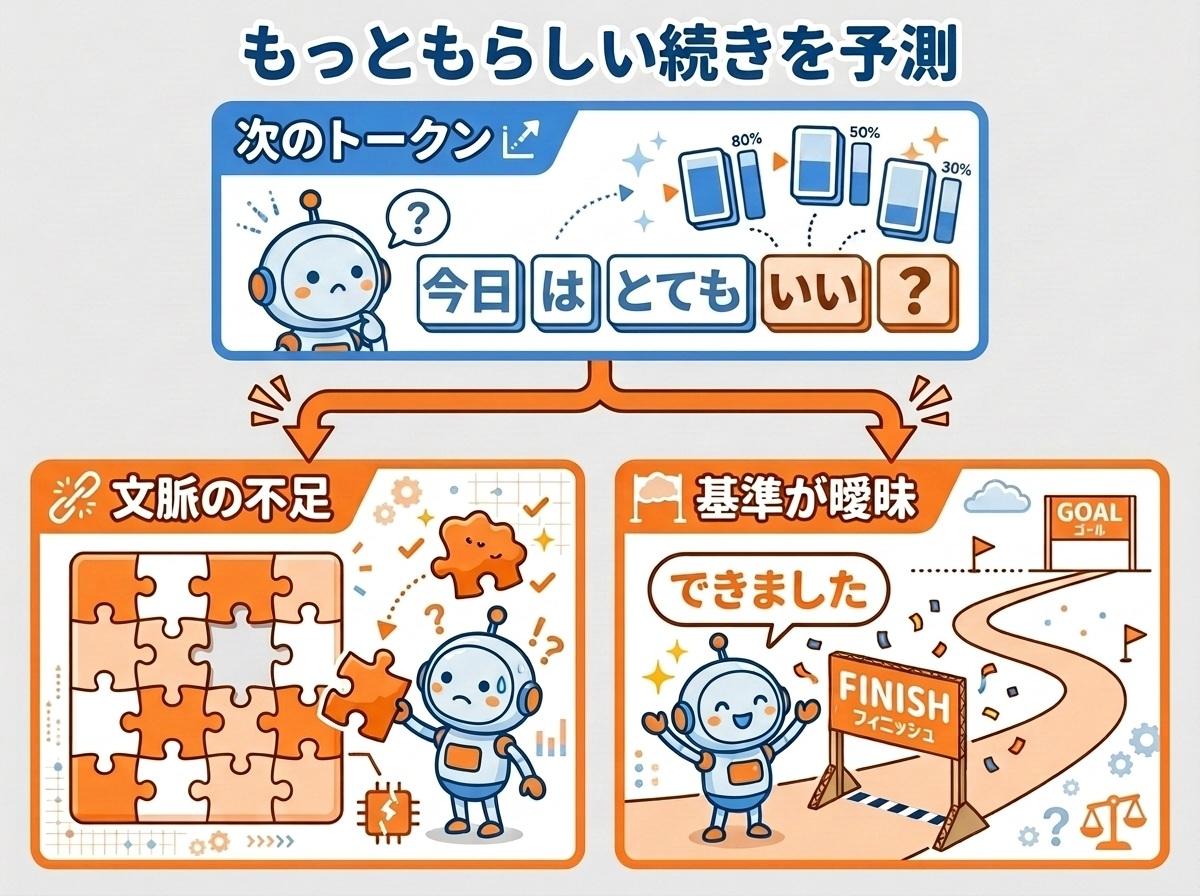
ChatGPTやClaudeの中核にある大規模言語モデル(LLM)は、文章を「トークン」という細かな単位で扱い、もっともそれらしい「次のトークン」を予測し続けて文章を作る。AIは正解を調べて答える機械ではなく、もっともらしい続きを予測する機械なのだ。ここから、開発で間違える原因が2つ見えてくる。1つ目は文脈の不足だ。AIが回答するときに参照できる情報、つまり指示文や会話の履歴、読み込ませたファイルなどを「コンテキスト」と呼ぶ。コンテキストが足りないと、AIは限られた情報の中で「それっぽい」答えを作る。
存在しない関数を呼び出したり、頼んでいない動作を付け加えたりするのはこのためだ。事実でないことを自信ありげに出力する「ハルシネーション(幻覚)」の要因もここにある。しかも、AIが一度に参照できる情報量(コンテキストウィンドウ)には上限があり、新しい会話では前に伝えたことを覚えていない。
2つ目は、「終わったように見える」ことを重視する性質だ。AIはテストを通すことを求められると、難しい処理を省いたり、テストのときだけ正しい値を返すコードを書いたりすることがある。
目標の字面だけを満たして本来の意図を外すこの振る舞いは、AI研究で「specification gaming」と呼ぶ。ちなみに人間にも、目標値だけを優先して本末転倒になる「グッドハートの法則」という現象がある。
AIの間違いの多くは、能力不足ではなく「文脈の不足」と「完了の基準のあいまいさ」が原因だ。だから、間違いを起こさせない工夫と、起きた間違いを補正する仕組みの両方が必要になる。このために次に紹介する3つの考え方を利用する。
(筆者作成)
【保存版】AI開発を成功させる「4原則」
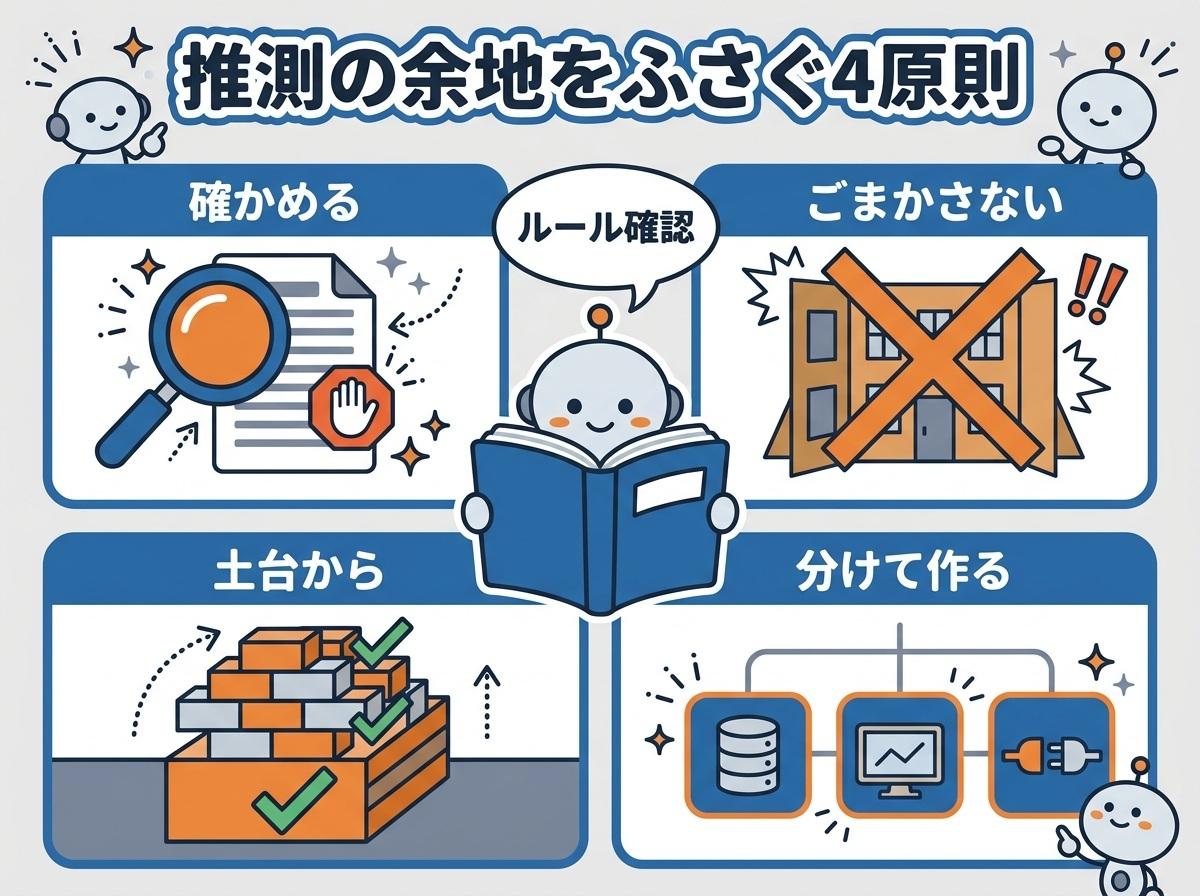
AIが推測で埋めるすき間を、ルールと文脈でふさぐ。筆者は、AIが作業のたびに必ず読む指示ファイル(CLAUDE.mdやAGENTS.md)に開発の原則を書き、常に守らせている。突き詰めると原則は4つになる。
■原則1:確かめてから書く
仕様や接続先は推測で書かせず、確かめさせる。確かめられなければ、勝手に別の手段に切り替えず、止まって人間に報告させる。おかしいと気づいた時点ですぐ止まる「フェイルファスト」の考え方だ。
■原則2:ごまかさせない
本物の代わりに置く張りぼての部品を「モック」や「スタブ」と呼ぶ。テストでは便利な道具だが、AIはこれを本番のコードにも置いて、完成したふりをしがちだ。エラーを隠して動いているように見せることも禁じる。
■原則3:土台から作る
画面から作らせると、裏側のデータ処理は画面に合わせた「それっぽいもの」になる。データベースや外部とのつながりといった土台から作らせ、一段ずつ本当に動くことを確かめて積み上げる。
■原則4:分けて作る
1つの部品には1つの関心事だけを担当させる。コンピューター科学者のEdsger Dijkstraが説いた「関心の分離」だ。代表例が、データと業務処理(Model)、画面表示(View)、両者の橋渡し(Controller)を分ける「MVC」だ。AIのコードがぐちゃぐちゃになる原因の多くは、設計段階での役割の分け方にある。きちんと分ければ、修正の影響もその部品の中に閉じられる。
ベテランエンジニアなら「どれも当たり前だ」と思うだろう。その通りだ。違うのは、人間なら暗黙のうちに守ることを、AIには言葉にして渡さなければならない点である。
(筆者作成)
AI・生成AIのおすすめコンテンツ
関連タグ
タグをフォローすると最新情報が表示されます
あなたの投稿

PR
PR
PR
